跟随每一步
时间复杂度
在十个数里找一个目标,挨个看一遍似乎也不麻烦。换成一百万个数呢?同一种办法仍然能找到答案,只是我们开始在意:为了这个答案,究竟要做多少工作?一个方法在小例子里显得方便,不代表数据变多后仍然合适。
这里比较搜索算法中的两种办法。一种从头逐个检查;另一种利用数已经排好顺序这一点,检查中间值后,排除不可能的一半。先试一个较短的列表,把每次比较看清楚,再增大列表。留意的不只是“谁赢了”,而是数据增加以后,工作量增加了多少。这种增长,才是我们想描述的。
我们暂时数指定的操作次数,不拿动画播放了几秒作结论。真实运行时间还与硬件、存储和实现有关。后面会出现描述增长的记号;到那时,它们都有刚才亲自数过的步骤作依据,不需要把它们当成一张新的记忆表。
先从一次查找开始
算法就是为解决一个问题而执行的一组步骤。假设我们有一列数,需要找到其中的某一个。线性查找从第一个数开始,把它与目标比较;如果不同,就继续找下一个。
用 表示数据个数,也就是输入规模。这里把“与一个元素比较”算作一次工作,用 表示比较次数。我们数的是工作量,还不是经过了多少秒。
0
10
点击播放或单步。我们要找 21,目前还没有比较。
选最后一个元素试一试。5 个数据需要比较 5 次,10 个就需要 10 次。一般来说,n 个数据中找到最后一个,或者确认目标根本不存在,都需要比较 n 次。这是最坏情况:在同样大小的输入中,所需工作量最多的情况。
这样的增长是线性的:数据总量翻倍,最坏情况下的比较次数也翻倍。我们用 ,读作“大 O n”,描述这个增长上界。O 括号里面的表达式指出增长的尺度,并不是某一个算法的名字。
把一个循环放进另一个,会发生什么?
for 循环会重复执行一段指令。现在让外层循环重复 n 次,并在每一次外层循环中,再让内层循环重复 n 次。观察内层怎样填完一整行,外层才会转到下一行。
for i = 0 … n−1: for j = 0 … n−1: mark(i, j)
外层循环选择一行。在这一行中,内层循环依次访问每一列。每一个着色格子代表执行了一次 mark(i, j)。
还没有标记任何格子。
这里假设标记一个格子的工作量是固定的,不随 n 增长。总共 n 行,每行 n 个格子。n 翻倍时,行和列都翻倍,所以循环体执行次数变成四倍。这叫平方增长。循环中的判断、计数器加一也会产生工作,但不改变主导的平方增长。
如果两个循环只是前后执行,没有嵌套呢?
第一个做 n 次,第二个再做 n 次,总共是 2n,而不是 n²,增长仍然是线性的 。嵌套的关键在于:外层每重复一次,整个内层都要重新执行。
一次比较能排除很多可能吗?
可以,但这里需要一个前提:数组已经从小到大排好序,而且可以直接访问中间位置。把中间值与目标比较。如果它太小,它左边的所有数也都太小,就可以一起排除;如果它太大,就排除右边。在剩下的区间中继续重复,这就是二分查找。
0
5
点击播放或单步。我们要找 33,目前还没有比较。
为了看清增长规律,先做一个理想的减半计算。减半一次大约剩下 个候选,再减半一次大约剩下 个。用 表示减半到只剩一个候选所需要的次数:
对数回答的是一个问题:“2 的几次方等于 ?”例如 8 → 4 → 2 → 1,共三次理想减半,因为 。输入翻倍,只需要再多减半一次。相比逐个检查时工作量也翻倍,这个增长慢得多。
减半次数不一定等于精确比较次数
刚才的理想减半计算说明了增长方向,还没有数完最后一次比较。在实际查找中,每次没找到目标,除了排除一侧,还会排除刚比较的中间项。若原来有 m 个候选,较大的一侧剩下 m 除以 2 后向下取整那么多个;“向下取整”就是取不超过它的最大整数。一直保留较大的一侧,就得到可能经过的最长路线。下面把最后一个候选也算进去,逐步推出精确上界,不再增加一个需要硬记的公式。
这里排序已经完成。把原本无序的数据排好序还需要额外工作,没有包含在这个查找次数中。我们用底数 2,是因为每步把候选大约减半。若改成按固定的 b 倍计数,次数 k 满足 。两边取以 2 为底的对数,就得到 ,再除以 ,得到 。只要 b 是固定的大于 1 的数,除数也是固定的正数,因此换底不会改变增长类别。
把最后一次比较也数进去
八项的中间位置取偏左的那一项时,左边三项、中间一项、右边四项。假设目标比所有项都大,每次都会留下较大的右半边;这就实际走出一条最长路线。每次推进前,你可以预测比较以后会剩多少项,用下一步的结果核对。
- 起初:8
剩一项并不等于已经知道答案:还得比较它,才能找到目标或排除它。因此一直数到零。每次把候选数除以二并向下取整;连续做这件事,等于最后对除以二的幂的结果取整。用 n 表示起始项数,n₀ 表示尚未比较时的候选数,nₖ 表示比较 k 次后剩下的候选数;右下角的小数字只记录已经做了几次比较。
括号表示向下取整,k 是已经比较的次数。候选数为零,恰好要求括号里的非负数小于一,也就是二的 k 次方大于 n。对数在这里回答“二要乘多少次才达到 n”;取严格超过它的最小整数,就数完了最坏情况。
这既是任何查找不会超过的上界,也是刚才那个“目标大于所有项”的例子确实达到的次数。它没有把排序的工作算在里面。
但我们一定要查到最后吗?
当然不是。回到线性查找,选择第一个元素:不管列表多长,一次比较就找到了。因此最好情况是 ,表示工作量不随 n 增长。同样长的列表,目标在中间与目标不存在时,实际工作量也可能不同。
假设一类输入总让查找在结束前 12 个位置停下来。对 ,比较次数就是 。省下的 12 次是固定的,随着 n 变大,真正增长的是 这一项。因此通常把它的增长描述简写为 。这里写 也属于同一个渐近增长类(只看 n 很大时的增长),但不如 直观。
时间复杂度描述算法的工作量怎样随输入规模增长。大 O 给出在输入足够大以后、允许相差一个固定倍数的增长上界。它本身并不等于“最坏情况”:前面的查找分析是我们主动选择了最坏情况。我们应该说明分析哪种情况,以及在数哪种操作。
这里 是固定倍数, 是固定的起始规模,它们都不随 n 改变。函数 g(n) 提供增长尺度。上界不一定最紧:线性工作量最终也可以被平方函数限制,但 O(n) 更清楚地描述了它。
找一条以后一直成立的上界
假设逐项处理各花三次操作,准备工作固定花十二次,总数就是 。我们想用一条更简单的直线 盖住它。C 必须选定以后保持不变;不能每看一个 n 就偷偷换一次。
一次数值比较只检查一个例子。要保证以后全部成立,把不等式两边同时减去 3n,剩下的问题就很清楚了。
取 C = 6,所有不小于 4 的整数 n 都成立。n 再增加,右边这个正的量只会增大,因此证明覆盖了以后全部情况,不只是三个例子。
即使刚才试过的某个 C 不成立,我们已经找到至少一个可行的选择:取 C = 6,从 n = 4 起始。大 O 要求的是存在这样一组选择,而不是每个 C 都成立。这就满足大 O 的要求:找到一个固定倍数和一个起点,从起点往后的操作数始终不超过它。这里得到 ;大 O 给的是上界,并不声称每项工作只花一次。
下面还会比较指数增长。想象要列出 n 道独立的是非题的所有答法:每加一道题,已有的每一种答法都能接“是”或“否”,总数就翻倍,因此有 种。这是在数所有组合,不是在数只回答一份题目的工作。
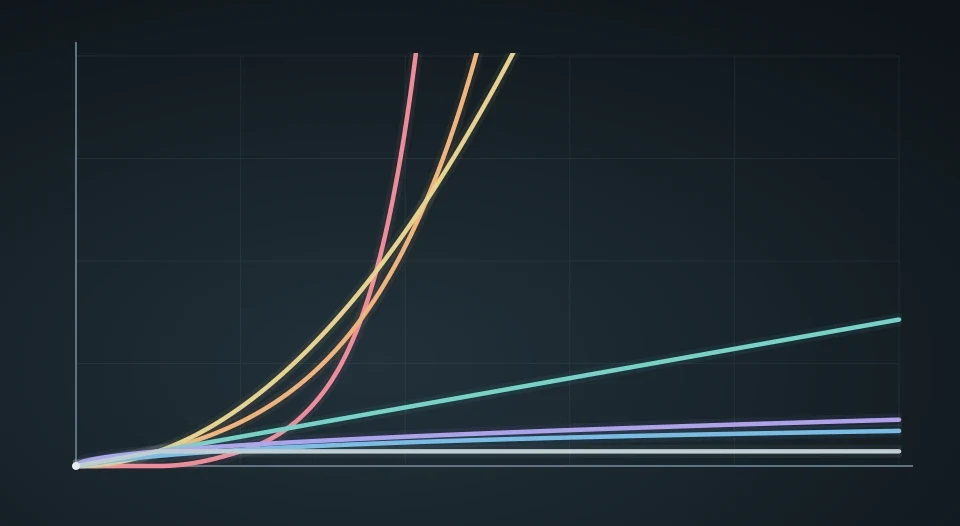
三根条共用从 0 到 的线性刻度。改变 时刻度一起伸展,右侧显示真实函数值。较短的条仍然可能在增长。
| n | ||||
|---|---|---|---|---|
| 4 | 2 | 4 | 16 | 16 |
| 8 | 3 | 8 | 64 | 256 |
| 16 | 4 | 16 | 256 | 65,536 |
| 32 | 5 | 32 | 1024 | 4,294,967,296 |
对于系数固定的多项式工作量,最高次项最终会主导增长。我们不需要只凭图猜测。例如工作量是 。当 时, 且 ,于是:
倍数 20 固定不变,因此这个工作量是 O(n²)。这正是数学·极限中的相对增长所讨论的主导项思想。指数、幂、根式和对数的增长速度不同,我们比较的是最终的增长规律,不只是一小段图像的陡峭程度。
检查理解:把输入规模翻倍
线性增长变成 2 倍;平方增长变成 4 倍;log₂ n 增加 1。这是在比较增长函数,不是在承诺每台真实计算机的运行时间都精确满足这些比值。