人工智能:从图灵之问到大语言模型
返回信息学目录1950 年,数学家艾伦·图灵在一篇论文的开头提出了一个很短的问题:**“机器能思考吗?”**七十多年后,我们可以向一个程序输入问题,得到一段通顺、细致的回答。这样的程序里面到底发生了什么?数一数哪些词经常相邻,就能做出一个猜下一个词的小程序,但这种办法能记住的信息很少。把词表示成**一串数**,就能用计算比较它们,并组合上下文的信息。这会引出**“注意力”机制**(让每个词参考句中其他词),它是 **Transformer** 的重要组成部分。这种结构被广泛用于语言模型。我们也会了解它的发展和训练方法。图片生成则给出了另一个问题:计算机怎样把一团噪声变成图像?**“扩散”方法**会让我们看到这个过程。
读这一页不需要会编程。我们会用到加法、乘法和少量乘方;新的符号会在使用它的地方说明含义。交互模型里的每一个数都是真实算出来的,你可以自己核对每一步。
机器能思考吗?
图灵的论文《计算机器与智能》1950 年发表在《心灵》(Mind)期刊上。他马上注意到自己这个问题的困难:要回答“机器能思考吗”,我们得先对“机器”和“思考”的意思达成一致,而人们在这一点上从来没有完全一致过。于是,他把这个问题换成了一个真正可以检验的问题。
他把它叫作“模仿游戏”。一位提问者坐在一个房间里,通过打字向另一个房间里看不见的两位回答者提问:一位是人,一位是机器。提问者只能读到打出来的回答,他的任务是判断哪一位是人、哪一位是机器。图灵认为,如果机器被当成人的次数,和一个真人被当成人的次数差不多,我们就很难再坚持说它不会思考。今天,人们通常把这个游戏叫作“图灵测试”。
论文里还有两个想法和这一页关系很大。第一,图灵做了一个预测。他写道,大约五十年后,只要机器有足够的存储,它就能把这个游戏玩得很好。那时普通提问者在提问五分钟后,正确认出它的机会不超过 70%。第二,他建议与其把一个成年人头脑里的规则一条条写出来,不如造一台会学习的机器。这台机器像孩子一样被教着学。请记住第二个想法,因为今天的人工智能正是这样做的。没有人给大语言模型逐条写规则,它的那些数是从例子里学出来的。
赢了这个游戏,是不是就证明机器在思考呢?人们至今还在争论,这一页也不打算给出结论。我们能做的,是一件更朴素、也更有用的事:一步一步看清楚,今天的机器在回答我们的时候,到底计算了什么。这样,每个人都可以对着这套机制,而不是对着一个谜,来判断图灵的问题。
七十年简史
“人工智能”这个名字,是图灵论文发表几年后才出现的:1956 年,达特茅斯学院为一次夏季研讨会起了这个名字。从那以后,这个领域一直在两种大思路之间来回。第一种是由人来写规则:如果程序要诊断疾病,就请专家列出症状和连接它们的规则。第二种是图灵说的会学习的机器:给程序看大量例子,让它自己调整内部的数,直到它的回答和例子一致。点选时间轴上的事件,读读发生了什么,以及它属于哪一种思路。
图灵提出模仿游戏,并建议制造会学习的机器。
按规则工作的程序遵循人提供的步骤;学习型模型则用例子调整内部的数值设置。两种办法各有用途,一个系统也可以把它们结合起来。更多数据和更快的计算,让学习方法能够处理更大规模的图像和语言任务。2017 年的《Attention Is All You Need》为机器翻译提出了 Transformer。下面的小例子会把注意力的计算展开,让每个数的来源都能被核对。理解这些数怎样组合信息,就能继续讨论文字生成时怎样选出下一个词元。这是一类重要的人工智能机制,并不代表所有人工智能。
猜下一个词
我们先从语言模型最简单的样子开始。读一读这个没写完的句子:“那只猫坐在……上”。你大概想到了“垫子”或“地板”,肯定不会想到“想法”。你是在猜下一个词,而且是凭经验在猜,因为你以前见过很多类似的句子。语言模型就是专门做这件事的程序:给它一段文字,它为每一个可能出现的下一个词给出一个概率。
这里的概率是一个 到 之间的数,表示在很多次尝试中,我们预计某件事发生的比例。如果某个词每 4 次里有 1 次接在后面,它的概率就是 。所有可能的下一个词的概率加起来等于 ,因为下一个位置上必定恰好出现其中一个词。
得到这些数最直接的办法就是数数。下面是一小组句子,我们把它叫作语料,也就是我们用来学习的文本。选一个词:语料中它出现的每个位置都会被标出,表格列出在这些位置后面出现过的每个词、出现了几次,以及这个次数除以总次数的结果。
| 下一个词 | 次数 | 概率 |
|---|---|---|
| 地毯 | 1 | |
| 垫子 | 1 | |
| 椅子 | 1 | |
| 合计 | 3 |
例如,在语料里,“在”后面一共出现了 3 个词:“垫子”“地毯”“椅子”各 1 次。所以“在”后面出现“垫子”的概率是 ,三个概率加起来是 。
现在按“写一句话”。程序从你选的词出发,随机抽出下一个词,每个词被抽中的机会等于它在表格中的概率。然后它把这个新词当作“前一个词”,重复同样的步骤,直到写出句号。“预测、选择、接上”是一种自回归生成过程:下一次选择使用已经写出的内容。这一课研究这种方法。利用两边文字填一个被遮住的词等语言模型任务,并不一定按这种顺序生成。
数数的办法有两个严重的问题。第一,它对没见过的组合一无所知。语料里“小猫”后面只出现过“坐”,所以计数模型会认为“小猫吃了鱼”不可能出现。可这是一句完全正常的话。第二,它只往前看一个词。在“她在巴黎住了十年,所以她能说一口流利的……”里,最合适的下一个词“法语”取决于前面的“巴黎”。只往前看一个词,我们只能看到“的”,它完全没说是哪种语言。我们可以改成数更长的词串,可那样一来,几乎每个词串都是新的,绝大多数计数都是零。
所以我们需要两样东西。第一,能表示“词和词相似”的办法,这样“骨头”就能借用我们对“鱼”的了解,因为两者都可以吃。第二,让每个词都能使用前文任何位置的信息的办法。接下来的几章就来搭这两样东西:用向量表示相似,用注意力往回看。
在语料里,“在”后面一共出现了 3 个词,其中“椅子”出现 1 次。计数模型给“在”后面出现“椅子”的概率是多少?
把文字切成小段
在模型能计算任何东西之前,文字必须先变成数。第一步是把文字切成一个个小块,叫作 token(词元),再给每一块一个编号,编号来自一张固定的列表,叫作词表。为什么不直接用整个词?因为词永远列不完:人名、错别字、新词、数字、其他语言……为什么不用单个字母?因为那样一句话会变成很长的序列,而单个字母本身几乎不带意思。真正的分词器走中间路线:常见的词各占一个 token,少见的词则由几个常见的小块拼起来。
9 个 token · 灰色芯片是单个字节(编号 0–255)。
在输入框里打字,看看切出来的小块。比如“机器学习”,我们的小词表里正好有“机器”和“学习”两块,分词器在每个位置都取它认识的最长一块,于是得到两个 token。每块芯片上写着这一块文字和它的编号,也就是这个 token 在词表中的号码。
再看看词表里根本没有的字会怎样,比如“猫咪”里的“咪”。它会被拆成计算机存储它时用的字节。一个字节是 8 位二进制数字,所以它有 种不同的取值。大多数汉字用三个字节存储,这里用十六进制写成 E5、92、AA。十六进制的数字是 0 到 9 再加上 A 到 F,这样每个字节正好用两个符号写下。编号 0 到 255 专门留给这 256 种字节,所以任何文字都能变成 token,不会出现“不认识”的情况。
词表又是从哪里来的?它也是从文本中学出来的。一种常用的方法叫字节对编码:从单个字符开始,反复把出现次数最多的那一对相邻小块合并成一块。下面在一个只有四个词的小语料上一步步演示,每个词出现的次数不同。
| 词 | 出现次数 | 当前的小块 |
|---|---|---|
| low | 5 | low |
| lower | 2 | lower |
| newest | 6 | newest |
| widest | 3 | widest |
第一步,e 后面跟 s 这一对,在 newest 里出现 6 次,在 widest 里出现 3 次,一共 9 次。s 后面跟 t 这一对也出现 9 次,没有哪一对出现得更多。两对次数相同时,分词器取在语料中先遇到的那一对,所以“es”成为一个新的小块。接着,“es”后面跟“t”也出现 9 次,于是得到“est”。合并几次以后,常见的结尾“est”和常见的词“low”都各自变成了一整块,而少见的字母组合仍然是分开的。真正的分词器会一直合并下去,直到词表里有几万到几十万个小块。粗略地说,一个英文 token 大约是四分之三个单词。
把小段变成一串数
现在每个 token 都有了编号。可是编号只是个名字:257 号(“猫”)和 258 号(“狗”)挨在一起并没有什么意义,300 号也不比 200 号“多”什么。我们想要带意思的数,让相似的词得到相似的数。办法是:不给每个 token 一个数,而是给它一串数。
按固定顺序排好的一串数叫作向量。如果只有两个数,比如 ,我们可以把它画成一支箭头:从坐标原点出发,向右 3 格、向上 2 格。三个数可以画成空间里的一支箭头。模型把每个 token 的向量存在一张大表里,叫作嵌入表:第 257 行存的就是“猫”的向量。把 token 变成向量,就是去查它那一行。
下面有 19 个词,每个词有 8 个数。为了让你读得懂这些数,我手工设计了它们,并给每个位置一个意思。第 1 个数表示这个词有多像动物,第 2 个数表示有多像交通工具,依此类推。选一个词,就能看到它的 8 个数。我们一次只能画出三个方向,所以图里只显示八个位置中的三个;你可以选显示哪三个,也可以拖动画面把它转过来。
当三条坐标轴是动物、交通工具和食物时,词聚成三团,各靠近一条轴。再看表示人的词:男人、女人、国王、女王、男孩、女孩都挤在中间,叠在一起。它们并不是在所有方面都相像,只是这个视角恰好没有显示它们不同的那些方向。把一条轴换成“人”,另一条换成“女性”,它们就散开了。
这是理解向量时最重要的习惯:一张图一次只能显示三个方向,可向量拥有全部方向。两个词在某个视角里看起来很近,在完整的一串数里却可能离得很远。
真实的模型也是这样工作的,只是数要多得多:最初的 Transformer 给每个 token 512 个数,今天的大模型用几千个,GPT-3 用了 12288 个。和我的表相比,有一点必须说明:真实模型里没有人决定每个位置的意思。这些数一开始是随机的,再由训练(第 10 章)慢慢调整。用法相似的词最后会得到相似的向量,但单独一个位置很少有“动物”这样清楚的意思。我们给位置贴上标签,只是为了让这些数读得懂。
两个向量有多像?
我们说过,相似的词应该得到相似的向量。那么,怎样把“相似”变成一个计算?先在二维里看,那里一切都画得出来。取两个向量 和 ,右下角的小数字 1、2 只是标出第一个数和第二个数。它们的点积,就是把对应位置的数相乘,再把结果加起来:
数更多时也一样:逐个位置相乘,再全部加起来。例如 ;;。
为什么它能衡量相似?拖动下面两支箭头的尖端,看读数怎样变化。两支箭头大致指向同一边时,对应的数往往同号,乘积为正,和就大。两支箭头互相垂直时,正的乘积和负的乘积相互抵消,点积为 。一支箭头是另一支的负数倍时,每个非零的对应乘积都为负,因此相加也为负。不过有一个问题:把一支箭头拉长到两倍,它的每个数都变成两倍,点积也变成两倍,可它的方向并没有变。
- 点积
- 长度
- 余弦相似度
- 夹角
为了比较方向而不把长度的影响算进去,我们需要知道每支箭头的长度。箭头 是一个直角三角形的斜边,两条直角边的长度分别是 和 。由勾股定理,它的长度是 。这也等于 ,因为 。数更多时,就在根号里照样多加几个平方。对于非零向量,把点积除以两支箭头的长度,就得到余弦相似度。零向量没有方向,也不能这样除。下面会把长度公式和比较方向的理由展开说明:
长度公式从哪里来
一支箭头向右走 a、向上走 b。我们需要从起点直达终点的长度 c,才能把“方向相同、只是整体更长”分开比较。横向和纵向相互垂直,它们与箭头组成一个直角三角形。先只取正的 a、b,把四个一样的三角形放进下面的大正方形。
绿色是四个三角形,金色是中间的正方形。大正方形的每条边由 a 和 b 接成。中间每条边都是一个三角形的斜边 c;相邻两边的夹角是直角,因为旁边两个锐角的和是九十度。一个三角形的面积是 :把它与一份翻转的副本拼起来,正好得到边长 a、b 的长方形。
现在用“大块减四个小块”求金色面积。同一个面积又等于边长 c 的平方,因此两种算法必须相等。
长度不取负数,所以取非负平方根。若坐标为负,用坐标的绝对值作为边长,平方后仍得到同一公式。某一条边为零时,箭头就是另一条边;两条都为零时,长度为零。零向量没有方向,接下来不能拿它的长度作除数。
把向量除以它的长度,相当于把它缩短或拉长到长度 ,而方向不变,所以这个数只取决于方向。不论两支箭头多长,方向相同时它等于 ,垂直时等于 ,方向相反时等于 。读数还显示它等于两支箭头夹角的余弦;下面接着推导为什么会这样,始终要求两个向量非零。
推导:为什么余弦相似度等于夹角的余弦
先看一个关于角的事实。在以原点为圆心、半径为 的圆上取两点,它们与水平轴的夹角分别是 和 。它们的坐标是 和 ,这正是余弦和正弦对单位圆上的点的意思。由勾股定理,两点距离的平方是 。展开后,对每个点用 ,就得到 。
现在把整个圆往回转 。两点之间的距离不变,但现在一个点在角度 处,即点 ,另一个点在角度 处。同样的计算给出距离平方 。两个结果描述的是同一段距离,所以 。
最后,把 写成 ,把 写成 。于是 ,而 正是两支箭头的夹角。再除以 ,就得到这个夹角的余弦。在三维中,两支箭头位于过原点的一个平面内,在这个平面里同样的论证成立。超过三维时,我们根本画不出这个角,于是就用这个公式来定义它;在能画出来的情形里,它和画出来的角一致。
现在把它用在我们每个词 8 个数的向量上。在下面的模型里选一个词:列表按余弦相似度给其他所有词排序,计算时用的是全部 8 个数,而不只是图里画出的三个。“猫”和“狗”几乎指向同一个方向,“猫”和“卡车”则不是。
- 狗
- 狮子
- 马
- 小狗
- 小猫
向量还可以做算术。取“国王”,减去“男人”,再加上“女人”:。减去“男人”,就去掉了国王和男人共有的部分(是人、体型),主要剩下“王室”;加上“女人”,又把“人”和体型加了回来,同时加上“女性”。结果最接近“女王”。学出来的词向量也有同样的现象,只不过是近似的,所以我们找的是最近的词,而不是完全相等的词。
哪一对向量的点积等于 0?
注意力:让小段互相看
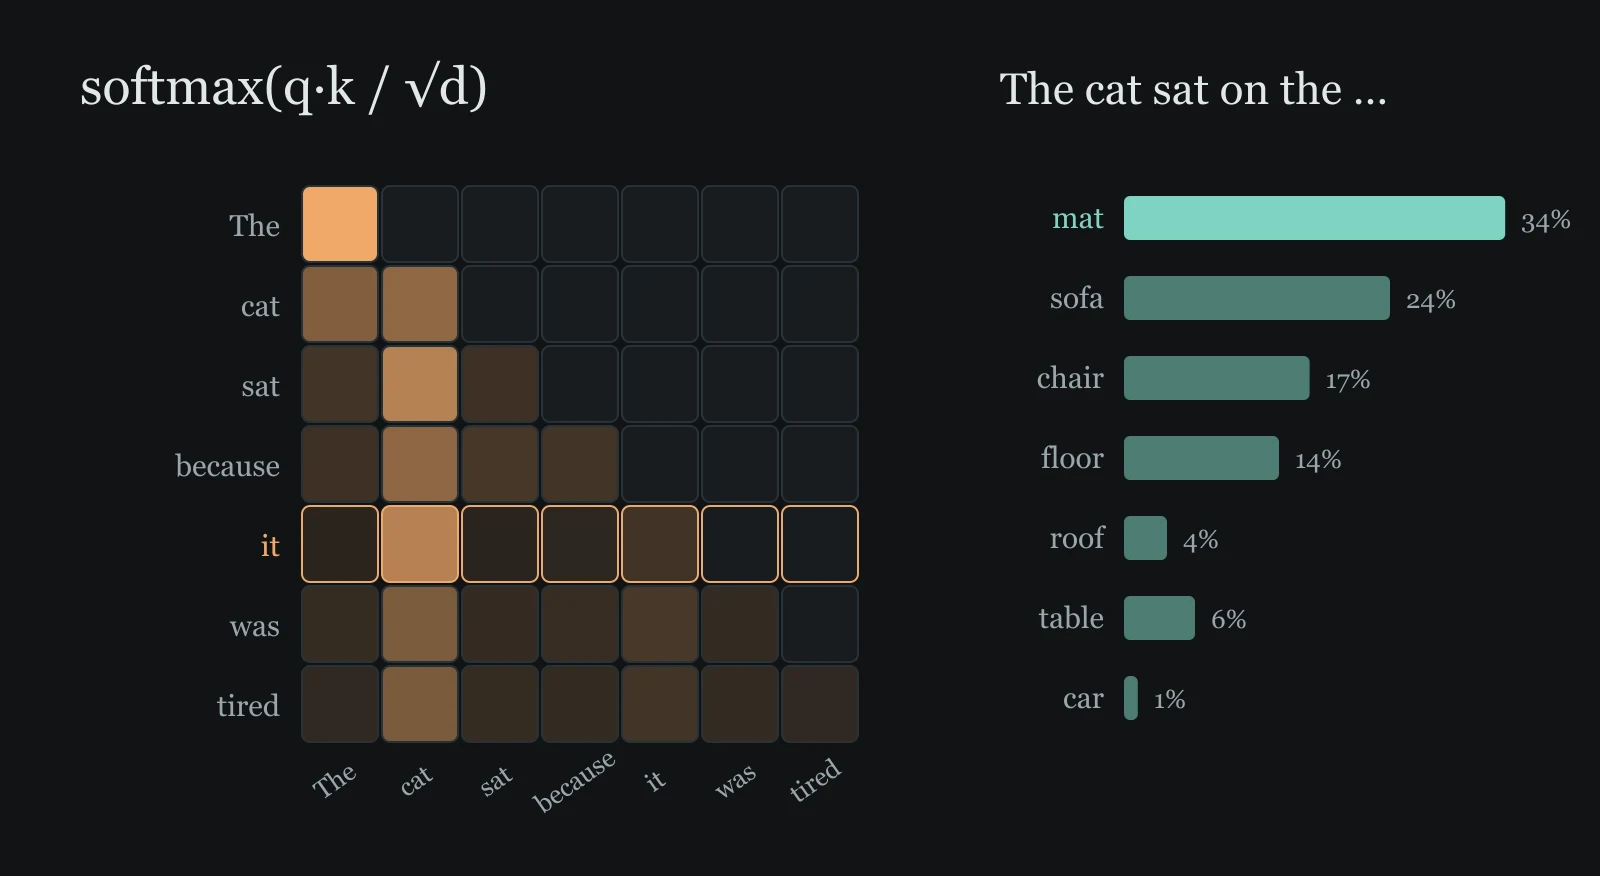
现在每个 token 都有了向量。可是从表里查出来的向量总是同一个,不管这个 token 出现在哪里。看这个句子:“那只猫坐下了,因为它很累。”嵌入表在每个句子里都给“它”同一个向量,可在这里,“它”指的是猫。要读懂这个句子,“它”的向量必须吸收来自“猫”的信息。而在“那条路封了,因为它被水淹了”里,同一个“它”需要的却是“路”的信息。所以,每个 token 都需要一种办法去看其他 token,并判断哪些对自己重要。注意力做的就是这件事。
注意力的工作方式很像一次搜索。每个 token 用自己的数算出三个新的向量:
- **查询(query)**:描述这个 token 在找什么;
- **键(key)**:描述这个 token 能向寻找者提供什么;
- **值(value)**:当别的 token 注意到它时,它传过去的信息。
对“它”来说,查询大致在说“我在找一个我能指代的事物”,而“猫”的键在说“我是一个事物”。查询和键匹配得好,点积就大,这正是上一章衡量相似的办法。所以计划是:把“它”的查询和它能看到的每个 token 的键比较,匹配得越好,传过来的信息就越多。
那么,token 怎样算出这些向量?在我们的例子里,每个 token 有 4 个数,顺序是 [事物,指代词,动作,描述]。查询和键各有 2 个数,这样就能画成箭头。为了把 4 个数变成 2 个数,模型保存了一张数表,叫作矩阵,算查询用的记作 。它对 4 个特征各有一行,每行有 2 个数,表示这个特征给查询加上什么。算一个 token 的查询时,把每一行乘以这个 token 在该特征上的数,再把四个结果加起来。“它”的 4 个数是 ,所以四行分别乘以 、、 和 :
用同样的办法,第二个矩阵 算出键,第三个矩阵 算出值。“猫”的 4 个数是 ,它的键是 ,主要在说“我是一个事物”。每个输出的数,都是 token 的 4 个数和矩阵某一列的点积,这就是为什么这种运算叫作“向量乘以矩阵”。
“它”和“猫”之间的分数,是“它”的查询和“猫”的键的点积,再除以 ,这里 是每个查询和键里数的个数。为什么要除,我们稍后解释。
分数可以是任何数,可正可负。我们想要的是权重:都是正数,而且加起来等于 。这样每个权重就表示一个 token 分到了多大份额的注意力。softmax 函数分两步把分数变成权重。第一步:以每个分数为指数求 的乘方。这里 是一个固定的数。指数是整数时,乘方就是连乘,例如 。分数不是整数时,乘方在这些整数之间平滑地补齐。用计算器就能算出,例如 。重要的有两点:对任何分数 , 都是正数;分数越大, 越大,所以分数的大小顺序保留了下来。
第二步:把每个结果除以所有结果的总和。每一份都除以同一个总和,各份额加起来就等于 ,这和第 3 章用次数除以总次数是同一个道理。设能看到的 个 token 的分数是 ,那么第 个 token 的权重是
对“它”来说,它能看到的 token 是 那只、猫、坐下了、因为 和它自己,分数分别是 、、、 和 。第一步约得 、、、 和 ,总和约为 。第二步:“猫”分到“它”的注意力的 ,“它”自己约分到 。
有一个有用的性质:给每个分数都加上同一个数 ,权重都不变。每个乘方都变成 ,同一个因子 出现在每一项和总和里,做除法时就约掉了。
最后,每个 token 的输出是值向量的加权平均:把每个能看到的 token 的值乘以它的权重,再加起来。对“它”来说,结果的 来自“猫”的值,所以“它”的新向量主要带着“猫”的信息。在模型里,各个值箭头按权重缩短后首尾相接,最后那个箭头尖就是输出。
还有一条规则。模型写文字时,一个 token 只能看它自己和它前面的 token,因为后面的还没有写出来。后面那些的分数被直接去掉,可以理解为分数是 ,而它的 乘方是 。这叫作因果遮罩。在模型里把它关掉,就能看到编码器——一次读入整段已写好文字的结构——会怎样做。
选一个“去看”的 token。左图显示它的查询(金色)和它能看到的那些 token 的键(灰色)。条形显示分数和 softmax 权重。右图把按权重缩短的值首尾相接,得到输出(金色)。下面的方格同时列出所有 token 的权重:行是“去看”的 token,列是“被看”的 token。
为什么要除以 ?点积要把 个乘积加起来。在真实模型里,每个查询和键有 64 或 128 个数,把很多乘积加起来,往往得到很大的分数。分数之间差得很大时,softmax 会把几乎全部权重都给一个 token。学习就会停滞:一个权重接近 的 token 几乎不影响结果,也就几乎得不到修正(第 10 章)。如果这些数像典型大小为 的随机数,那么 个乘积之和的典型大小约为 。所以除以 ,就能把分数拉回到典型大小约为 。在模型里关掉这次除法:“它”对“猫”的权重从 升到 ,其他权重都变小了。
推导:为什么点积的典型大小是
设点积为 ,其中每个数都是独立的随机数,平均值为 ,平方的平均值为 。为了衡量 的典型大小,我们看 的平均值,再开平方。
把 展开,得到 个平方项 ,以及许多 的交叉项 。由于 和 独立,每个平方项的平均值是 。每个交叉项里都含有比如 这样的因子,它和这一项里的其他数都独立,平均值为 ,所以整个交叉项的平均值是 。
所以 的平均值是 , 的典型大小是 。除以 之后,不论 是多少,分数平方的平均值都是 。学出来的查询和键并不完全是这样的随机数,所以这是选择缩放比例的依据,而不是精确的定律。
一个注意力头在每个位置算出一份值的加权组合;它不一定只承担一种固定、能用日常语言命名的关系。Transformer 会让好几个头并排工作,每个头有自己的三个矩阵,再把它们的输出拼起来。切换到注意力头 B:换了一组矩阵,同样的 token 现在找的是最近发生的动作,而不是被指代的事物。最初的 Transformer 每层有 8 个头,大模型有几十个。没有人告诉一个头该找什么;和词向量一样,它的矩阵是学出来的,只有一部分头最后有清楚的意义。
如果一行里每个注意力分数都加上 ,softmax 权重会怎样?
搭起 Transformer
注意力让 token 之间交换信息。Transformer 的一层在注意力前后加上几个更简单的步骤,整个模型就是许多这样的层叠起来,每层有自己学出来的数。点选图中的每个部分,看看它做什么、为什么需要它。
多个注意力头(第 7 章)让每个 token 从它能看到的 token 那里收集信息。
跟着两个数算一次归一化
相加后的数值可能整体偏大,也可能分散得很开。减去共同的偏移,可以让它们围绕零分布;调整分散程度,则让它们不至于相差太大。下面只用两个数,每次推进都会保留前面的结果,方便确认新数从哪里来。这里暂时把最后可学习的缩放设为 1、偏移设为 0。
真实层还可以把这些结果逐项乘上学出来的系数,再加学出来的偏移。那以后平均值、方差就未必是 0、1。我们拆开算的是这一步的算术,并不是声称归一化能保证整个模型学得好。
为什么需要位置?注意力通过点积和加权平均把 token 组合起来,这两样运算都不管 token 站在哪里。把句子打乱顺序,输出也只是跟着打乱而已。在下面的演示中,两个句子都由“狗”“咬”“人”三个词组成,我们在三个 token 上运行第 7 章的注意力头 A,不加遮罩。比较两个句子里“狗”的输出。
没有位置时,两个输出完全相等,模型就分不出是谁咬了谁。给每个 token 加上位置向量(句子中每个位置有一个固定的模式)以后,两个输出就不一样了,后面的层可以利用这种差别。
原论文用不同波长的正弦和余弦波来构造位置向量。今天许多模型改成按 token 的位置,把每个查询和键旋转一个角度(旋转位置编码),这样点积就取决于两个 token 相隔多远。
在 2017 年的论文里,Transformer 是为翻译设计的,比如把英语翻译成德语。它分成两半。编码器一次读入整个英语句子,不加遮罩。解码器一个 token 一个 token 地写出德语句子,加上因果遮罩。它在每一层还要注意编码器的输出,以便看到英语原句。这叫作交叉注意力。基础版模型每一半有 6 层,每个 token 512 个数,8 个注意力头,约 6500 万个学出来的数,用 8 块 GPU 训练了大约 12 小时。它的大号版本在英德和英法翻译上创造了新纪录。GPT 系列语言模型只保留了解码器那一半,也不需要交叉注意力:它读入已有的文字,写出下一个 token。
选读:论文里的那一行公式
论文把第 7 章写成了一行:。这里 是一张表,它的每一行是一个 token 的查询; 和 分别是键和值的表。 读作“ 的转置”,就是把 的行变成列。
表 乘以表 ,在第 行第 列得到查询 和键 的点积,也就是一次得到全部分数。对每一行做 softmax,就得到我们模型中那张权重方格。再用这张方格乘以 ,每一行都得到值的加权和,也就是一次得到全部输出。这一行公式里没有新东西,它只是把我们对每个 token 的计算合在一起做,而这正是 GPU 做得最快的事。
选出下一小段
回到“那只猫坐在……上”。经过最后一层后,模型为最后一个 token 留下一个向量 。为了给每个候选的下一个 token 打分,它计算 和这个 token 的向量的点积:分数大,说明 和这个候选词指向相近的方向。这些原始分数叫作 logits。在我们的小例子里,向量有 4 个数,表示 [可以坐的东西,室内,柔软,食物],,“垫子”的向量是 。所以“垫子”的 logit 是 。
softmax,也就是注意力里用过的那个函数,把 logits 变成概率。然后模型必须做出选择。总是选概率最大的 token 听起来很合理,可那样写出的文字重复、乏味,同一个问题每次的回答也完全一样。所以模型通常采用抽样:随机抽一个 token,每个 token 被抽中的机会等于它的概率。按几次“抽一个”,再按“抽 100 个”,比较每个词被抽中的次数和它的概率。
那只猫坐在____上
0 次. 绿色条:概率;细金色条:实际被抽中的比例。
温度 在 softmax 之前去除每一个 logit。 时什么都不变。为了看清 的作用,比较 logits 为 和 的两个候选词。它们概率的比是 ,因为 softmax 里的总和对两者相同,会约掉;这又等于 。“垫子”和“沙发”的 logits 是 和 , 时比值是 , 时是 。所以温度低于 会拉大差别,让可能的 token 更占优势; 接近 时,模型几乎总是选第一名。温度高于 会缩小差别,不常见的词就出现得更多。
还有两个控制项,在抽样之前把一长串不太可能的 token 截掉。top- 只保留最可能的 个 token。top- 从最可能的开始依次保留,直到保留下来的概率加起来至少为 ;所以模型有把握时它保留得少,没把握时保留得多。两种情况下,保留下来的概率都要除以它们新的总和,让它们重新加起来等于 。
抽出一个 token 后,模型把它接到文字后面,再运行一遍,选出下一个。这和第 3 章计数模型的循环完全一样,只是概率好得多。一段长回答要经过成千上万次这样的步骤,每一步都要完整地经过每一层。
温度非常接近 时,抽样会怎样?
这些数从哪里来?
我们遇到过的所有数——嵌入表、每个注意力头的矩阵、前馈网络的矩阵——都叫作参数。GPT-3 有 1750 亿个参数。它们的值从哪里来?一开始它们是很小的随机数,训练用一个非常简单的任务来调整它们。拿一段真实的文字,遮住下一个 token,让模型预测。然后轻轻推动每一个参数,让正确的 token 本来能更可能一点。
为了朝正确的方向推,我们需要一个数来说明预测错得有多厉害。如果模型给正确 token 的概率是 ,我们就用损失 。这里 是自然对数,它是“求 的乘方”的逆运算: 就是 要乘方多少次才得到 的那个指数。 时损失是 ; 时约为 ; 时约为 。模型有把握而且答对时,损失很小;正确 token 的概率越接近 ,损失就越大,没有上限。
为什么用对数?模型给整段文字的概率,是其中各个 token 概率依次相乘的积。乘积的对数等于对数之和。设 、,那么 ,所以 。因此,整段文字的损失就是各个 token 的损失之和,每个 token 都可以当作一个单独的小例子来处理。
接下来是“推”。对每个参数,微积分给出它的斜率:参数增加一点点时,损失变化得有多快,也就是它的导数。对于可微、梯度不为零的损失,沿反方向走足够小的一步,可以让附近的损失下降;随意取一个大步并没有这个保证。这叫梯度下降,步子的大小由学习率 (读作 eta)决定。为了看清算术,下面的小实验直接调整三个输出 logits,不是在训练整个网络。对这些 logits,斜率的形式简单得惊人:对正确的 token 是 ,对其他每个 token 就是它自己的概率 。正确 token 记 ,其他记 ,那么一步就是
所以每一步把正确 token 的 logit 提高 ,把每个错误 token 的 logit 降低 。在下面一步步训练;正确答案是“垫子”。一开始三个 logits 是 、 和 ,所以 ,损失约为 。用 走一步后,“垫子”的 logit 提高 ,变成 ;“沙发”和“月亮”分别降低它们的概率 和 。每走一步,正确答案都更可能一些,而且 越接近 ,增加得越少。学习率越大走得越快,但在有几十亿参数的真实模型里,步子太大会冲过头,损失会上下乱跳,所以学习率要仔细选择。
| 下一个词 | logit | 改变量 | ||
|---|---|---|---|---|
| 垫子 · 正确答案 | 0.50 | −0.68 | +0.68 | |
| 沙发 | 0.80 | 0.44 | −0.44 | |
| 月亮 | 0.20 | 0.24 | −0.24 |
- 步
- 0 / 12
- 损失
推导:斜率 是怎么来的
把 logits 记作 ,把它们的 乘方之和记作 。如果 号 token 是正确的,,所以损失是 。这里用了 和 。
现在只改变一个 logit 。如果 , 这一项以 的速率变化,否则不变,所以这一项的变化率是 。对 用链式法则: 的导数是 ,而 变化时 以 的速率变化,因为 的导数是 。所以 的变化率是 。两部分相加,损失对 的斜率就是 。
前面各层的参数通过中间计算影响最后的损失。反向传播利用链式法则,把这些局部变化率有次序地合起来,高效地求出每个参数该怎样调整;它不是另外提供正确答案的方法。下面会把两个局部变化率相乘,看看前面的参数为什么收到这样的调整。预测下一个 token 只是一种训练目标,之后还可以加入指令例子、偏好反馈等目标,因此不能推断一个助手的所有行为都只来自这一项训练。
前面的参数怎样收到调整
先用一条能算到底的链:输入是 2,参数是 w,预测是 ,希望得到 3。误差记为 。为了不让正负误差抵消,把误差平方作为损失 。现在只改变 w,追踪它怎样一路影响损失。
若 w 增加 h,误差就增加 2h。把变化后的误差代回平方,与原来的平方相减,就得到损失的变化。h 不为零时,把这个变化除以 h;让 h 逐渐接近零,所得比值就趋近此处所需的斜率。
也能把它拆成两段:w 每增加一点,误差按两倍变化;平方对误差的局部变化率为 2a,因为 。两段相乘得到 。反向传播就是把这类局部关系有次序地合起来;这里的简单链让乘法的来源看得见。
η 是你选择的步长。用 0.1 调整后,还原参数并试试 0.3,就能比较步长的影响:方向仍是逆着斜率,大步却会越过合适位置,反而把损失推高。所以“小一点”需要结合这个函数判断,不能保证任何步长都有效。最小损失在 ,因为它恰好使误差为零。下面的读数保留三位小数,所以用约等号 ≈;每次调整仍使用未舍入的数,不能把显示出来的近似数当作精确数计算。
Transformer 从哪里来
2017 年以前,处理语言的标准工具是循环神经网络(RNN)。它一次读一个 token,就像一个人用手指指着字一行行往下读,同时带着一个记忆向量往前走。每一步,它把记忆和新 token 的向量组合起来,得到新的记忆。读完最后一个 token,这个记忆就应该装下整个句子。
这种设计有两个弱点。前面 token 的信息要经过后面的每一步,才能在最后被用上,一路上会逐渐变淡,就像一句话沿着一排人传下去。LSTM(1997)加上了“门”——学出来的开关,决定保留什么、忘掉什么、加入什么——让记忆保持得更久,但并没有消除这个问题。第二个弱点是速度:第 50 步需要第 49 步的记忆,所以这些步骤不能同时计算,而 GPU 恰恰是在同时做成千上万次计算时最快。
2014 年,一种叫“序列到序列”的翻译系统用一个 RNN 把英语句子读成一个记忆向量,再用第二个 RNN 根据它写出法语句子。把整个句子挤进一个向量是一个瓶颈,长句子翻译得很差。同一年,巴赫达瑙、赵和本吉奥让负责写的 RNN 在每一步都能回头看负责读的 RNN 的全部记忆,并按每个记忆与当前需要的匹配程度算出权重。这就是注意力,当时它只是 RNN 的一个帮手。
Transformer 的作者们问:如果让注意力承担全部工作,把逐步传递的记忆完全去掉,会怎样?这就是标题《Attention Is All You Need》的意思。每个 token 一步就能到达前面任何一个 token,在整个训练序列已提供时,许多位置能够并行计算,同时用遮罩挡住后面的答案。但通常的自回归生成仍要先选出这一个 token,才能决定接下来那个,新词元的选择仍然有先后依赖。比较下面两种设计:选定文字的长度,看看第一个 token 的信息要走多少步才能到达最后一个。
- 从第一个到最后一个 token 的步数
- 必须一个接一个完成的步骤
- 每个头的比较次数
- —
注意力也有代价。加上因果遮罩时,第 个 token 要和 个 token 比较,所以 个 token 的文字在每一层的每个头里需要 次比较。
要把它加起来,可以把这个和写两遍,一遍正着写,一遍倒着写,再把两行逐项相加:、……每一对都等于 。一共有 对,所以和的两倍是 ,和就是 。1000 个 token 就需要 次比较;长度翻倍,工作量大约变成四倍。这就是长文字计算昂贵的原因,也是后来许多研究致力于让注意力更便宜的原因。时间复杂度一课专门讲这种增长。
从 Transformer 到今天的大模型
不到一年,就出现了两种使用 Transformer 的方式。GPT(OpenAI,2018)保留了解码器,用一大批书籍训练它预测下一个 token,这叫预训练。得到这个模型后,研究者用针对具体任务的小型标注数据继续训练,这叫微调。BERT(Google,2018)保留了编码器,训练它利用两侧的文字填出被遮住的词,这让它适合搜索、分类这样的任务。两者都说明,大量原始文本上的训练能学到可供多种任务使用的语言规律。
接下来是规模的增长。GPT-2(2019)有 15 亿个参数;GPT-3(2020)有 1750 亿个,用约 3000 亿个 token 训练。GPT-3 展示了一件新事:不再做任何训练,只要在提示里写几个例子,它就能完成任务。比如写几对英法句子,再给一个新的英语句子。2020 年,研究者测量发现,当参数、数据和计算量一起增长时,损失会平稳地、可预测地下降。这叫作规模定律。2022 年的 Chinchilla 研究发现,许多模型相对于它们读过的文字量来说太大了。比较好的比例大约是每个参数配 20 个训练 token。Chinchilla 有 700 亿个参数,用了 ,也就是 1.4 万亿个训练 token。
这张图显示公开发表的模型大小。纵轴上每一条网格线都是下面一条的 10 倍。之所以要这样的刻度,是因为大小从 6500 万一直到 6710 亿,大约跨了四个“十倍”;如果用普通刻度,2020 年以前的所有模型都会被压扁在底部。点选一个点,看它的详细信息。有几个最强的模型从未公布大小,所以图中没有画出它们,而不是去猜测。
GPT-3 · 2020 · 参数: 1750 亿
一个只学会接着写文字的模型,还算不上助手:你问它一个问题,它可能接着写出更多问题。又经过两个阶段的训练,它才变成了助手。在指令微调中,模型用人写的“请求加好回答”的例子来训练。在基于人类反馈的强化学习(RLHF)中,人们比较模型给出的两个回答。第二个模型学会预测人们更喜欢哪一个。然后调整语言模型,让它给出这个第二个模型打分高的回答。InstructGPT(2022)表明,人们更喜欢一个这样训练、只有 13 亿参数的模型的回答,而不是原来 1750 亿参数的 GPT-3 的回答。2022 年 11 月发布的 ChatGPT 把这一成果带给了大众。训练 Claude 的公司 Anthropic 提出了一种相关的方法,叫“宪法式 AI”(Constitutional AI)。模型还会按照一份写好的原则清单,评判并修改自己的回答。
从那以后,基本的机器一直是 Transformer,只是它的许多部分得到了改进。
把前馈网络拆成许多较小的网络,叫作“专家”,再由一个小的路由器把每个 token 只送给其中少数几个。这样模型可以拥有非常多的参数,而每个 token 只用到一部分:DeepSeek-V3(2024)有 6710 亿个参数,但每个 token 只用 370 亿个。
模型一次能注意到的文字量,从 GPT-3 的 2048 个 token 增长到几十万个,有些模型达到一百万个甚至更多。这靠的是更省的注意力算法和更好的位置编码。
图片、声音和视频被切成小块,变成向量,于是同样的注意力可以把它们和文字混在一起处理。
从 2024 年起,一些模型通过在答案可以检验的题目上做强化学习,学会在回答之前先写出一长串中间步骤。这大大提高了它们在数学和编程上的表现。
模型被训练去调用搜索引擎、运行代码、操作软件,从而完成需要很多步的任务。
今天最有名的模型系列包括 GPT(OpenAI)、Claude(Anthropic)、Gemini(Google)、Llama(Meta)、DeepSeek 和通义千问 Qwen(阿里巴巴)。有些公开参数,任何人都可以下载;有些连大小都不公布。
有些东西并没有改变,值得说清楚。模型仍然是根据从训练文本中学到的概率,一次产生一个 token。它可能流利地说出错误的内容,这叫“幻觉”,因为一个可能的续写不一定是真的。除非给它搜索之类的工具,它的知识停在训练数据为止。至于它的计算在多大程度上算是“思考”,这正是图灵的问题,至今仍没有定论。
扩散模型:去掉噪声来画画
刚才研究的文字生成器一次选择一个 token。接下来研究另一种生成图像的方法,叫扩散。我们先要知道图片在计算机里是什么:它是一格一格的像素,每个像素存一个表示亮度的数(彩色图片则存红、绿、蓝三个数)。一张 的灰色小图,就是 个数。
现在加上噪声:给每个像素加一个随机数,这些随机数服从钟形的正态分布,大多数接近 ,少数较大。分很多步慢慢地加,同时每一步把原图的亮度数乘以较小的系数;缩小的是数值贡献,不是图片的宽度或高度,图片就逐渐变成纯粹的噪声。第 步之后,像素是
这里 是原来的图片,(读作 epsilon)是噪声,(读作“alpha bar t”)是原图保留下来的份额:开始时是 ,最后几乎降到 。所以图片是两种成分的混合:原图乘以权重 ,噪声乘以权重 。拖动滑块加噪声,读数会带着一个像素走一遍这个公式。为什么取平方根?因为它们的平方加起来正好是 :。只有在明确的模型条件下,这样才保持方差为 1:干净数据这个随机量与独立噪声的方差都为 1。它并不表示任意一张固定照片的可见对比度保持不变。对一个固定的原始像素,只有噪声是随机的,其方差是 1 减去 alpha-bar。下面的推导会区分这两种情况,并说明为什么出现平方。
- 保留份额
- 一个像素:
加噪声很容易,也不需要学习。巧妙的是把它倒过来。我们在几百万张图片上训练一个神经网络,任务很简单:给它一张带噪声的图片 和步数 ,让它猜加进去的噪声 。这个任务很容易准备,因为带噪声的图片是我们自己做出来的,知道正确答案。网络一旦能猜出噪声,把上面的公式变形,也就能猜出干净的图片:
字母上的小帽子表示“估计值”。推导方法是:在加噪公式两边同时减去 ,右边只剩 ;再把两边同时除以 。
要画一张新图,就从纯噪声出发,把步骤倒着走一遍。每一步都先猜出干净的图片,算出这个猜测所对应的噪声。然后在稍低一点的更低噪声水平上把两者重新合起来。这里用加噪公式,把 换成 。开始时猜出来的是模糊的平均;噪声越来越少,猜测就越来越清楚;到最后一步 ,结果就是最后的猜测本身。这种走法叫作 DDIM;最初的方法 DDPM 每一步还会再加一点新的噪声。
一整张图片的数太多,没法画成一个点,所以下面的模型用最小的“图片”:只有 2 个数的单个点。训练数据是沿着一颗心形排列的 240 个点。在左边的标签页里加噪声,看心形化成一团圆圆的云。在右边的标签页里生成:500 个纯噪声的点一步步走回心形。选中一个点,可以跟踪它的路径,以及每一步做出的猜测。
- 保留份额
我们的小模型不需要训练网络,因为它完全知道那 240 个训练点。这时,对干净点的猜测是训练点的加权平均;和注意力一样,权重由 softmax 从分数算出。训练点 的分数,表示 能多好地解释这个带噪声的点 。怎样得到分数呢?加噪过程会把 缩小成 ,所以这是干净点 在加入噪声之前所在的位置。量出 到这个位置的平方距离,就得到了它们相差多少的一个量:距离越短,解释得越好。把这个平方距离除以噪声份额的两倍 ,并加上负号,距离较短的点就会得到较高的分数:
为什么要除以噪声份额?生成刚开始时,噪声份额 很大,即使离得较远的训练点,分数也和最好的那个相差不多;许多点分享权重,猜测就是模糊的平均。接近结束时,噪声份额非常小,最近的那个点几乎拿走全部权重,猜测就变得清晰。这和注意力里的 softmax 加权平均完全一样:带噪声的点是查询,训练点既是键也是值。选读部分推导这个分数。
推导:为什么起作用的是平方,以及小模型的分数从哪里来
随机数的分散程度用方差来衡量:它离自己平均值的距离的平方的平均。取 ,其中 、 独立,平均值都是 。 的平均值等于 。独立且平均为 ,使 的平均为 ,所以 的方差是 。把像素值缩放到方差为 ,噪声的方差也是 ,取 、,每一步的方差都是 。
再看分数。如果干净的点是 ,那么 ,所以噪声一定是 。这里假设各坐标的噪声独立,且服从标准正态分布。其概率密度正比于 ,其中长度平方就是各噪声坐标的平方和。密度比较的是落在同样小的邻域内的可能性,并不是某一个精确实数有正的概率。代入上面求出的噪声,“来自 ”这个解释的似然正比于 ,也就是 的“分数”次方。
在看到 之前,每个训练点的可能性都一样。由贝叶斯公式, 来自 的概率,就是它的可能性除以所有可能性的总和,这正是对分数做 softmax。平均平方误差最小的猜测,是各个可能的干净点按这些概率加权的平均,这就是小模型使用的公式。
为什么把可能的干净点加权平均
上面的点模型先假设每个存储的干净点同样可能。固定当前带噪声的位置后,某个干净点能产生这份观测的密度越大,它得到的权重越高。共同的先验概率和高斯密度常数会在分子、分母中约掉,剩下各个指数分数除以它们的总和。
这些权重仍没有告诉我们该输出哪一个数。我们还要说明目标:如果用平方误差评价猜测,怎样让平均损失最小?先只看一个坐标。候选干净数记为 ,权重为 ,加权平均记为 ,我们的猜测记为 u。
把“猜测到候选”的差拆成“猜测到平均”与“平均到候选”。展开平方以后,中间项消失:平均值的定义保证加权偏差的总和为零。
右边第二项不随猜测 u 改变,第一项是非负的平方,在 时为零。因此平方误差下最好的猜测是这个加权平均。二维时把两个坐标的平方误差相加,各自做同样的推理即可。它一般不同于“挑概率最大的一个点”;我们明确选择了平方误差这个评价方法。
这个小模型明确保存了 240 个干净点,每次估计都从这些点计算。噪声水平很小时,权重集中到附近的存储点,输出因而趋向这个有限集合。真实扩散模型改为从例子中学习一个函数;这个函数可以组合出新结果,也可能记忆或复现训练材料。网络大小有限,并不意味着它不会记忆。这个点模型演示的是它选定的经验分布,不能用来保证生成结果一定原创,也不是所有图像模型的完整机制。
像“垫子上的一只猫,油画风格”这样的提示,是怎样控制画面的呢?文字先由一个 Transformer 变成向量。去噪网络在每一步都通过交叉注意力(和翻译用的 Transformer 一样)去注意这些向量。于是它的猜测被拉向与文字相符的图片。为了省计算,Stable Diffusion(2022)在图片的压缩版本上完成整个过程,而不是逐个像素处理。这叫潜空间扩散。许多更新的图像和视频模型,干脆直接用 Transformer 作为去噪网络。于是这一页的两半在这里会合:注意力和扩散如今一起工作。
在加噪过程中,最开始 时, 是多少?
回到图灵的问题
让我们回到图灵。1950 年,他提出了一个只看对话的测试,也提出了一种会学习、而不是一条条规则编出来的机器。今天的语言模型正是这样的学习机器。它有一张向量表,有让 token 互相参考的注意力,还有每个 token 内部的小网络。几十亿个参数被调整过,用来预测海量文字中的下一个 token。
这算不算思考,人们还在讨论。在我们研究的简化生成器中,每次选择下一个 token,都依赖学出来的数与已经提供的上下文。完整的助手还可以结合写好的指令、检索和其他程序工具。看清这个学习得到的计算过程,有助于我们核对事实,分清流利表达与可靠证据,并提出更有用的问题。