生物学 · 从分子到证据
怎样比较两份 DNA 样本?
假设两个带标签的管子里装着从不同地方采来的材料。两者可能都有人体细胞,也都有 DNA。看一眼管子,无法判断里面的 DNA 是否来自同一个人。我们需要找到能测量的特征,还要弄清楚:测量结果吻合,到底说明什么。
我们跟着一个小例子,从细胞走到选定的 DNA 区域,再经过复制,最后看到条带。实验仪器可以在三维空间里检查;旁边的分步图会把真实仪器藏在管子里的分子过程展开讲清楚。下面所有图谱与频率数字都为教学虚构。
样本不是肉眼可见的指纹
细胞是构成活组织的小单位。我们许多细胞都有细胞核,也就是被一层膜围住的内部区域。细胞核里有染色体。染色体由很长的 DNA 分子和包装 DNA 的蛋白质构成。这些蛋白质负责把长链收拢起来;这一课比较的是 DNA 上的碱基顺序,不是这些蛋白质。分子是一群连接在一起的原子。DNA 是一种很大的分子,由一个个核苷酸连接而成。核苷酸上的碱基有四种,用 A、T、C、G 表示;序列就是沿着一条链排列的碱基顺序。往下读时,先记住三个词:DNA、碱基、序列。
人与人之间的 DNA 序列大部分相同。所以,我们并不是寻找每个人独有的、完全不同的分子形状,而是选择几个可能出现可测差异的位置。这些测量结果合在一起,叫作 DNA 图谱。“DNA 指纹”是这种比较的名称,不是拍下一个长得像手指指纹的分子。
下面第一站先展示采样场景。选择一站后,用“下一步”查看说明。实验台保持稳定视角,不会在你阅读时自行旋转或跳动。接下来几节,我们再回到试管里面发生的事情。
1/3 · 有标签的样本管
样本从头到尾都要带着标签。即使测量完全正确,拿错了别人的样本,结论仍然会错。
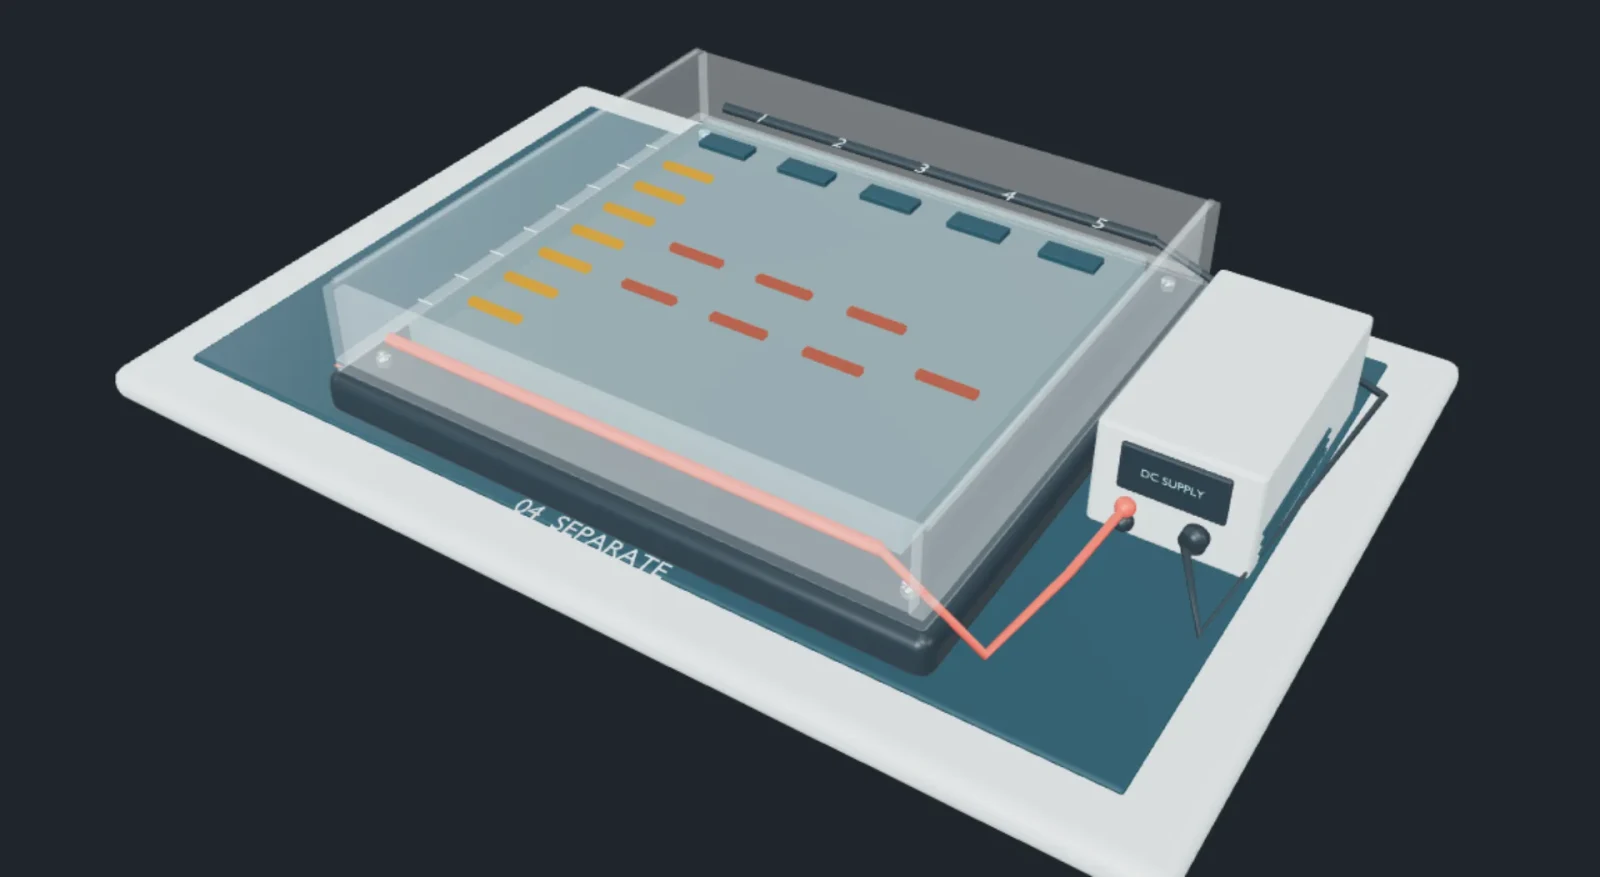
拖动可检查仪器;镜头不会自行旋转。观察凝胶可选择“从上方看”,转动后可以复位。这里是教学模型,不是处理生物检材的操作指导。
人与人之间,究竟什么可以不同?
考虑短序列 GATA。在某个选定位置,它可以一个接一个出现:GATA GATA GATA。这里重复了三次。另一份对应染色体在相同位置可能有更多或更少次重复。这样把短序列首尾相接重复的区域叫作短串联重复,简称 STR。我们比较的这个位置叫作位点。
对于本例使用的普通成对染色体,一个人从两位生物学亲本各继承一份。所以每个位点读出两个重复次数,例如 8 和 11。某个位点的一种版本称为等位基因。这里“等位基因 8”指重复八次的版本,不是第八条染色体,也不是整个 DNA 分子有八份。
先把三件事分开:位点是位置;重复次数描述这里的一种版本;两个数合起来描述这个人在该位置的情况。重复区域不一定在制造蛋白质的基因里面。我们的 A、B、C 是虚构位点名,不是在统计 DNA 字母 A 和 C 的数量。
把重复次数变成长度
DNA 通常有两条互补的链:A 配 T,C 配 G。一组配对叫一个碱基对,缩写为 bp。因此,沿双链有 132 个配对位置,就说长 132 bp;虽然两条链合起来有 264 个单独碱基,但长度不是把两条链的碱基数相加。
我们会复制重复区域,以及它两侧的固定部分。在虚构位点 A,两侧固定部分合计 100 bp。每个 GATA 重复再贡献 4 bp。八次重复的部分长 ,所以完整复制片段长 ;十一次则为 。
两端固定,只改变重复次数
每个红色 GATA 小块表示 4 个碱基对。两块灰色固定端合计表示 100 个碱基对。灰色部分在屏幕上压缩画出,所以请比较数字,不要用画出的宽度计算。
- 第 1 份长度
- 第 2 份长度
- 不同长度数
- 2
两份长度不同。它们的复制片段形成两组,所以在这个理想的清洁样本里,当前位点应有两条带。
用 表示重复次数, 表示测得的长度,刚才的计数就给出 。要求重复次数,需要知道重复部分有多长。减去固定的 100 bp,得到 。每次重复占四个 bp,所以用剩下的长度除以四,就得到 。例如测得 152 bp,其中重复部分长 bp,包含 次重复。因此,在本模型中,这个片段有十三次重复。
A 与 B 即使都是八次重复,片段也不一定一样长:本例 B 的固定部分有 160 bp,所以八次重复长 。必须保留位点标签。真实等位基因还可能有不完整重复或其他序列差异;这里的整次数算式特意不包含这些情况。
从细胞得到可用的提取物
复制区域之前,要先从采集物中释放 DNA。配好的溶液打开细胞膜和核膜。蛋白质等物质可能妨碍后面的复制反应,所以提取过程还要除去杂质,并把 DNA 收集在适合后续反应的液体中。具体步骤随样本和方法而变;打开细胞只是第一部分。
在实验台选择“释放 DNA”。离心机里大的转子就是带着管子旋转的部分。这里让它静止,方便你看清管子的位置。旋转有助于分离物质,却不会读取 DNA 序列。管子的标签让提取物始终能对应原样本;独立工具与对照样本还能帮助发现污染。
提取空白对照不加入采集来的样本,却同样经过流程。如果后面在这份对照中检出 DNA 信号,就可能提示污染。因此,阴性对照即使没有显眼条带,也很重要。本课画的是理想清洁样本;真实实验室必须检查 DNA 的量与质量,之后才能解释结果。
复制之前,先选定区域
提取物有许多位置的 DNA,但我们只想看选定的 STR 区域,而且这些区域的量可能不足以清楚测量。因此,我们使用聚合酶链式反应,也就是 PCR,给选定区域制造许多副本。选择区域必须成为复制过程的一部分;把无关片段都复制一遍,并不能直接回答当前问题。
蛋白质是另一类大的生物分子,其中一些能帮助化学反应发生,叫作酶。DNA 聚合酶就是这样一种酶。这里,它参照模板,把新的核苷酸连接成链。模板碱基决定要加入哪一种互补碱基:A 对应 T,T 对应 A,C 对应 G,G 对应 C。但酶需要一段已有的短链,才能从末端接着延伸。我们提供的这段起始短链叫作引物。
DNA 链两端的化学结构不同,分别叫 端和 端。DNA 聚合酶只能向 端继续添加,所以新链沿 到 的方向增长。要读懂下图,我们暂时不必学习糖分子的原子编号,但必须区分这两种末端。引物是一小段现成的短链,贴着模板放好,酶就从它的末端接着补下去。两条模板的方向相反,所以下面的引物也必须朝相反方向。
为什么需要两种引物?
两条灰色长线代表原来的两条链;相对的小短线代表碱基。这是方向示意,不是分子的真实形状。金色段是引物,青色段是从引物接着构建的新 DNA。
原来两条链的化学方向相反。“”和“”是两种化学结构不同的端点名称,不是距离,也不是角度。碱基按互补规则配对: 配 , 配 。
这对引物结合在所选区域两侧、两条模板上的对应序列处。之后,前一轮的副本又成为模板,新的副本逐渐具有由两种引物共同确定的边界。为什么偏偏是第三轮?看下面三步:第一步只确定一端,第二步补齐另一端,第三步才得到两条链都等长的产物。在从一份较长双链开始的理想模型中,边界都精确的双链产物在完成第三轮时首次出现。不是加热把一段 DNA 从染色体上切下来,而是反复复制产生了这些边界确定的片段。
为什么循环能得到许多副本
回到实验台的“复制指定区域”。加热使双链分开,降温让引物结合,再到适合酶延伸的温度。仪器反复执行这些阶段。图中示意为约 95 °C、58 °C 和 72 °C,但具体设置取决于实际引物、酶和方案,不能把一个温度当作所有 PCR 的通用操作要求。
理想的翻倍模型
我们从一份边界已经确定的双链目标片段开始。每次理想循环都完整复制两条链:一份双链变成两份双链。改变循环数时,请保留这个起点前提。
每一对线代表一份完整双链副本。一次循环后:。两次后:。这样重复乘 ,一共乘 次,就记作 。这里数的是双链片段,不是单条链。
理想翻倍说明了为什么反复复制能把少量起点变成较强信号,但不代表真实反应会永远完美翻倍。原料会成为限制,酶可能失去活性,复制效率也会改变,反应最后会接近平台。并且,以长染色体为起点的早期循环会产生边界不同的产物。上面的简单计数特意从边界已经确定的目标片段开始。
让不同长度分开
现在有了许多副本,可我们还需要测长度。在这种分离的通常条件下,DNA 骨架带负电。电荷决定物体受到的电作用,异号电荷相互吸引。两电极间的电压建立电场;电极就是与电源连接的导电接触部分。电场使带负电的 DNA 朝正极移动。这给出了运动方向,但仅有方向还不能把长短分开。
为了分离,我们加入有孔隙的材料:凝胶。里面有带着微小通道的网状结构。对于相同类型的 DNA,在适合的条件下,短片段更容易穿过,固定时间内移动得更远。这种观察到的长度分离,是模型采用的物理起点。屏幕上便于阅读的间距是教学安排,不是某种凝胶的真实运动公式。
加样孔把样本放在起点。一孔对应一条泳道,也就是这份样本通过凝胶的路径。许多一样长的片段聚集起来,经过检测形成可见条带。另设一条泳道,放一组已知长度的片段,就得到像尺子一样的 DNA 长度标准。如果一条带比某条长片段标准带走得更远,它对应的片段就更短。
在实验台选择“按长度分离”,再选“从上方看”。可以播放分离、暂停,或者拖动进度。只切换当前位点,样本泳道的标签始终不变。A 处 132 bp 比 144 bp 短,所以走得更远;它们对应八次与十一次重复。下面的数值比较也会把结果列出,不需要精确拖动才能读懂。
保留样本标签,再逐项比较
现在把虚构的未知样本与三份参考样本比较。参考样本指已知来自某个人的材料。本例假设每份样本只有一个人的 DNA,测量无误,每个等位基因都被检测到。在这些前提下,即使只有一个位点的数对不同,也说明图谱不吻合。只看 A 相同还不够,要继续检查 B 和 C。
逐个位点读取与比较
加样孔在上方、负号旁边。DNA 朝下方正号移动。第 1 泳道旁的数字是已知片段长度,单位为碱基对。把样本条带的高度和标准对照,再看下面的表。
真实凝胶需要检测方法才能显示 DNA。这幅亮色图代表检测结果,并不是 DNA 天然发光。各个位点分别显示,带间距特意放大。
| 泳道 / 样本 | 重复次数 | 片段长度 |
|---|---|---|
| 1 · 标准 | 4, 6, 8, 10, 12, 14, 16 | 已知长度 |
| 2 · 未知样本 | 8 / 11 | 132 / 144 bp |
| 3 · 人员 1 | 8 / 11 | 132 / 144 bp |
| 4 · 人员 2 | 8 / 11 | 132 / 144 bp |
| 5 · 人员 3 | 9 / 9 | 136 / 136 bp |
人员 1 与未知样本同有 的 8/11 和 的 10/12,但 是 7/9,而未知样本是 6/9。人员 2 的三对数都相同。人员 3 的三个位置都不同。因此,我们保留每对数字及其位置,而不是只数有多少条带大概相似。两个不同位点,回答的是两个不同的问题。
遗传怎样限制这些数对
相同类型的图谱也可以检查一种亲子关系是否符合遗传。本例中,每对普通染色体,孩子从两位亲本各得到一份。先假设没有新突变,也没有测量错误。 处孩子是 10/12,母亲是 7/10。相同的 10 可以来自母亲;母亲没有 12,所以另一位亲本必须提供 12。
处再做一次:孩子 8/9,母亲 5/8,另一位亲本需要提供 9。 处孩子 9/14,母亲 11/14,另一位亲本同样需要提供 9。所以本例要求另一位亲本在 有 12、 有 9、 有 9。如果孩子的两个数在某位亲本中都有,来源就可能不唯一;必须检查两种分配,不能机械地“减掉第一个数”。
逐个位点读取与比较
加样孔在上方、负号旁边。DNA 朝下方正号移动。第 1 泳道旁的数字是已知片段长度,单位为碱基对。把样本条带的高度和标准对照,再看下面的表。
真实凝胶需要检测方法才能显示 DNA。这幅亮色图代表检测结果,并不是 DNA 天然发光。各个位点分别显示,带间距特意放大。
| 泳道 / 样本 | 重复次数 | 片段长度 |
|---|---|---|
| 1 · 标准 | 4, 6, 8, 10, 12, 14, 16 | 已知长度 |
| 2 · 母亲 | 7 / 10 | 128 / 140 bp |
| 3 · 孩子 | 10 / 12 | 140 / 148 bp |
| 4 · 成人 A | 8 / 11 | 132 / 144 bp |
| 5 · 成人 B | 12 / 13 | 148 / 152 bp |
成人 A 在 A 处没有 12,所以本例在这里不相容。成人 B 有三个所需的数,因此这项简单检查不能排除此人,但并不能确认生物学亲缘关系。真实亲子分析还需要更多位点、人群信息与明确统计假设,并考虑突变和实验不确定性。
是否吻合与证据有多强,是两个问题
同一对数可以出现在不同人身上。因此,接下来不只是问“线条相同吗”,而是问“在一个明确的其他解释下,这种图谱出现得有多常见”。人群频率表示某个数值在指定人群中出现的比例。我们用虚构频率说明一种简单计算,把它与真实案件评估分开。
为什么比较多个位点会更有区分力
在这个虚构例子中,假设某个指定人群里,与样本无亲缘关系的人,在 A 处这对数吻合的概率是 ,B 处是 ,C 处是 。还假设这些吻合事件相互独立:知道 A 吻合,不会改变 B 或 C 吻合的概率。这些数是教学假设,不是人群统计数据。
3,000 的十分之一是 ,所以 A 处期望有 300 人吻合。“期望”是反复随机选取人群时的平均,并不保证某一组恰好有这么多人。这个 3000 不是统计数据,而是三个比例的乘积:10 × 20 × 15 = 3000。三个位点都吻合,就大约对应 3000 人里的 1 人。
回答的是:在指定人群与独立性假设下,随机选一位无亲缘关系者,拥有同样三对数的概率是多少?它不表示“吻合的人有 的概率是无辜的”,也不表示“有 的概率没有亲缘关系”。这些反过来的问题,需要其他信息,并比较不同解释。
亲属会共享遗传来的 DNA,普通 STR 图谱通常也无法区分同卵双胞胎。微量样本还可能经过间接转移、发生降解、受到污染,或混有其他人的 DNA;很弱的信号可能漏掉某个等位基因。因此,真实解释需要经过验证的方法与专业判断,一张整齐的三位点图不能消除这些问题。
从凝胶条带到仪器曲线
平板凝胶容易看清泳道与距离。许多法医 STR 仪器改用装有聚合物介质的细管分离带标记片段,这叫毛细管电泳。在经校准的条件下,较短片段更早经过检测器。光使附着的荧光标记发光,片段经过时,检测器记录信号。
先把原始到达时间与已知长度标准比较,换算为估计片段长度。接着画图:横轴放片段长度,纵轴放信号强度。一个清楚的等位基因会在对应长度附近形成一个检测峰,取代凝胶中某个位置的条带。峰不是分子长得像山,而是片段经过检测器时,测得信号发生了变化。
同一份未知样本,改画为峰
132 与 144 bp 的两个峰,对应重复次数 8 与 11,也就是凝胶中未知样本在 A 位点的两种长度。这里的峰高是示意,不是 DNA 含量估计。
颜色标记与经过验证的长度范围帮助仪器区分位点。不能因为一个未知峰碰巧靠近另一峰,就把它归到同一个位点。本课特意把 A、B、C 分开,让这项对应关系看得见。真实报告除了图谱,还要包含对照、质量检查与解释限制。
亲自检验这条思路
A 处片段长 148 bp,有几次重复?
先减固定的 100 bp:。每次重复贡献 4 bp,所以 次。直接拿 148 除以 4,会把两端固定部分错误地算进重复区域。
两份染色体的重复次数相同,为什么可能只有一条带?
两种扩增片段一样长,因此一起移动。条带包含来自两份染色体的大量片段,并不表示一份遗传拷贝消失了。
A、C 相同而 B 不同,本例理想比较算吻合吗?
不算。图谱包含每个被测位点的数对,B 不同就是图谱不同。这里采用清洁、单一来源、无误差的假设;真实差异需要调查原因。
随机吻合概率 ,是否给出了某人有罪的概率?
不。它描述的是在指定假设下,随机选取的无亲缘关系者具有该图谱的概率,不描述一个人的行为、DNA 怎样转移,也不描述有罪概率。