Seguir cada paso
Complejidad temporal
Buscar un objetivo entre diez números revisándolos uno por uno no parece difícil. ¿Y entre un millón? El mismo método sigue encontrando la respuesta, pero empezamos a preguntarnos cuánto trabajo requiere conseguirla. Que un método resulte cómodo en un ejemplo pequeño no significa que siga siendo adecuado al aumentar los datos.
Compararemos dos métodos de búsqueda. Uno revisa los valores desde el principio; el otro aprovecha que están ordenados y, tras inspeccionar el valor central, descarta la mitad imposible. Prueba primero una lista corta para seguir cada comparación y después amplíala. No observes solo quién gana, sino cuánto aumenta el trabajo cuando crecen los datos. Ese crecimiento es lo que queremos describir.
Por ahora contamos operaciones especificadas, sin sacar conclusiones de los segundos que dura la animación. El tiempo real también depende del hardware, el almacenamiento y la implementación. Más adelante aparecerán símbolos para describir el crecimiento; entonces tendrán como referencia pasos que ya has contado, sin convertirse en otra tabla que memorizar.
Empecemos por una búsqueda
Un algoritmo es un conjunto de pasos que se ejecutan para resolver un problema. Supongamos que tenemos una lista de números y queremos encontrar uno de ellos. La búsqueda lineal empieza por el primer número y lo compara con el objetivo; si es distinto, pasa al siguiente.
Llamamos al número de elementos: el tamaño de la entrada. Aquí una unidad de trabajo consiste en comparar un elemento con el objetivo. representa el número de esas comparaciones. Contamos trabajo, no segundos transcurridos.
0
10
Pulsa reproducir o avanza un paso. Buscamos 21; todavía no hemos hecho ninguna comparación.
Prueba a seleccionar el último elemento. Con 5 datos hacen falta 5 comparaciones; con 10, hacen falta 10. En general, encontrar el último de n datos o comprobar que el objetivo no existe requiere n comparaciones. Este es el peor caso: el que exige más trabajo entre entradas del mismo tamaño.
Este crecimiento es lineal: al duplicar la cantidad de datos, también se duplica el número de comparaciones del peor caso. Usamos , que se lee «O grande de n», para describir esta cota superior de crecimiento. La expresión entre paréntesis indica la escala del crecimiento, no el nombre de un algoritmo concreto.
¿Qué ocurre si ponemos un bucle dentro de otro?
Un bucle for repite un bloque de instrucciones. Hagamos que el bucle exterior se repita n veces y que, en cada repetición, el interior también se repita n veces. Observa cómo el bucle interior completa toda una fila antes de que el exterior pase a la siguiente.
for i = 0 … n−1: for j = 0 … n−1: mark(i, j)
El bucle exterior selecciona una fila. Dentro de ella, el bucle interior visita sucesivamente cada columna. Cada celda coloreada representa una ejecución de mark(i, j).
Todavía no se ha marcado ninguna celda.
Suponemos que marcar una celda requiere una cantidad fija de trabajo, que no crece con n. Hay n filas de n celdas. Al duplicar n, se duplican tanto las filas como las columnas y el cuerpo del bucle se ejecuta cuatro veces más. Esto se llama crecimiento cuadrático. Las comprobaciones del bucle y los incrementos del contador también requieren trabajo, pero no cambian el crecimiento cuadrático dominante.
¿Y si los dos bucles se ejecutan uno después del otro, sin anidarse?
El primero se ejecuta n veces y el segundo otras n: en total son 2n, no n², y el crecimiento sigue siendo lineal, . La clave del anidamiento es que, por cada repetición exterior, se ejecuta de nuevo todo el bucle interior.
¿Una comparación puede descartar muchas posibilidades?
Sí, pero aquí necesitamos que el arreglo esté ordenado de menor a mayor y que podamos acceder directamente a la posición central. Comparamos el valor central con el objetivo. Si es demasiado pequeño, todos los de su izquierda también lo son y podemos descartarlos juntos; si es demasiado grande, descartamos los de la derecha. Repetimos en el intervalo restante: esta es la búsqueda binaria.
0
5
Pulsa reproducir o avanza un paso. Buscamos 33; todavía no hemos hecho ninguna comparación.
Para ver cómo crece el trabajo, empezamos con un cálculo ideal de divisiones por la mitad. Tras una división quedan aproximadamente candidatos; tras dos, unos . Si es el número de divisiones necesarias para llegar a un solo candidato, entonces:
El logaritmo responde a esta pregunta: «¿A qué potencia hay que elevar 2 para obtener ?». Por ejemplo, 8 → 4 → 2 → 1 requiere tres reducciones ideales a la mitad, porque . Duplicar la entrada solo añade una reducción más. Frente a revisar uno a uno, donde también se duplica el trabajo, este crecimiento es mucho más lento.
El número de reducciones a la mitad no siempre coincide con el de comparaciones
El cálculo ideal anterior muestra cómo crece el trabajo, pero aún no ha contado la última comparación. En una búsqueda real, cada vez que no encontramos el objetivo descartamos un lado y también el elemento central recién comparado. Si había m candidatos, el lado mayor conserva m dividido entre 2, redondeado hacia abajo; redondear hacia abajo significa tomar el mayor entero que no supera ese valor. Conservar siempre el lado mayor da la ruta más larga posible. Abajo incluimos también el último candidato y deducimos paso a paso una cota superior exacta, sin añadir otra fórmula que haya que memorizar.
Aquí los datos ya están ordenados. Ordenar unos datos inicialmente desordenados requiere trabajo adicional, que no se incluye en este recuento de búsqueda. Usamos base 2 porque cada paso reduce aproximadamente a la mitad los candidatos. Si contáramos por un factor fijo b, el número de pasos k satisfaría . Tomando logaritmos en base 2 en ambos lados obtenemos ; al dividir entre resulta . Siempre que b sea un número fijo mayor que 1, el divisor también será una constante positiva, por lo que cambiar de base no cambia la clase de crecimiento.
Contar también la última comparación
Al escoger como centro de ocho elementos el de la izquierda de los dos centrales, quedan tres a la izquierda, uno en el centro y cuatro a la derecha. Si el objetivo supera todos los elementos, siempre conservamos la mitad derecha más grande: esto recorre realmente un camino de longitud máxima. Antes de avanzar, predice cuántos candidatos quedarán y compruébalo con el siguiente paso.
- Al principio:8
Que quede un elemento no significa conocer la respuesta: hay que compararlo para encontrar el objetivo o descartarlo. Por eso contamos hasta cero. Cada vez dividimos la cantidad de candidatos entre dos y redondeamos hacia abajo; repetirlo equivale a dividir por una potencia de dos y redondear al final. Escribimos n para la cantidad inicial, n₀ para los candidatos antes de comparar y nₖ para los restantes tras k comparaciones. El subíndice solo cuenta las comparaciones ya realizadas.
Los corchetes indican redondeo hacia abajo y k cuenta las comparaciones realizadas. Que no queden candidatos exige exactamente que el número no negativo dentro de los corchetes sea menor que uno, es decir, que dos elevado a k supere n. Aquí el logaritmo responde «¿cuántas veces debe multiplicarse dos para alcanzar n?». Tomar el menor entero que lo supera estrictamente completa el conteo del peor caso.
Esta cantidad es tanto una cota que ninguna búsqueda supera como el número alcanzado por el ejemplo anterior de «objetivo mayor que todos los elementos». No incluye el trabajo de ordenar.
¿Tenemos que buscar siempre hasta el final?
Por supuesto que no. Vuelve a la búsqueda lineal y elige el primer elemento: por larga que sea la lista, basta una comparación. Por tanto, el mejor caso es , lo que indica que el trabajo no crece con n. Incluso con listas de igual longitud, el trabajo real puede ser distinto si el objetivo está en medio o no existe.
Supongamos que cierta clase de entradas hace que la búsqueda se detenga siempre 12 posiciones antes del final. Para , el número de comparaciones es . Las 12 comparaciones ahorradas son una cantidad fija; al aumentar n, lo que realmente crece es el término . Por eso solemos abreviar su descripción de crecimiento como . Escribir también corresponde a la misma clase de crecimiento asintótico —la que considera el crecimiento para n grande—, pero resulta menos claro que .
La complejidad temporal describe cómo crece el trabajo de un algoritmo con el tamaño de la entrada. La O grande da una cota superior de crecimiento para entradas suficientemente grandes, permitiendo un factor multiplicativo constante. No significa por sí misma «peor caso»: en el análisis anterior elegimos estudiar ese caso. Debemos indicar qué caso analizamos y qué operación contamos.
Aquí es un multiplicador fijo y es un tamaño inicial fijo; ninguno cambia con n. La función g(n) proporciona la escala de crecimiento. Una cota superior no tiene por qué ser la más ajustada: una función cuadrática también acaba acotando un trabajo lineal, pero O(n) lo describe con más precisión.
Encontrar una cota superior que siga siendo válida a partir de cierto punto
Supongamos que procesar cada elemento cuesta tres operaciones y la preparación cuesta doce fijas: el total es . Queremos acotarlo con una recta más sencilla, . Una vez elegido C, debe quedar fijo; no podemos cambiarlo para cada n.
Una comparación numérica solo comprueba un ejemplo. Para garantizar todos los casos posteriores, restamos 3n a ambos lados de la desigualdad y vemos claramente qué falta demostrar.
Con C = 6, se cumple para todo entero n mayor o igual que 4. Al aumentar n, el miembro derecho positivo también aumenta; por tanto, la demostración abarca todos los valores posteriores, no solo los tres ejemplos.
Aunque algún C probado antes no sirva, ya encontramos una elección válida: C = 6 a partir de n = 4. La notación O grande exige que exista una elección así, no que todos los C sirvan. Hemos encontrado un múltiplo fijo y un punto de partida desde el cual el número de operaciones nunca lo supera. Obtenemos : O grande da una cota superior, sin afirmar que cada elemento solo cueste una operación.
Abajo compararemos también el crecimiento exponencial. Imagina que enumeramos todas las respuestas posibles a n preguntas independientes de sí o no: cada pregunta nueva permite añadir «sí» o «no» a cada respuesta anterior, duplicando el total; por tanto, hay posibilidades. Estamos contando todas las combinaciones, no el trabajo de responder una sola vez al cuestionario.
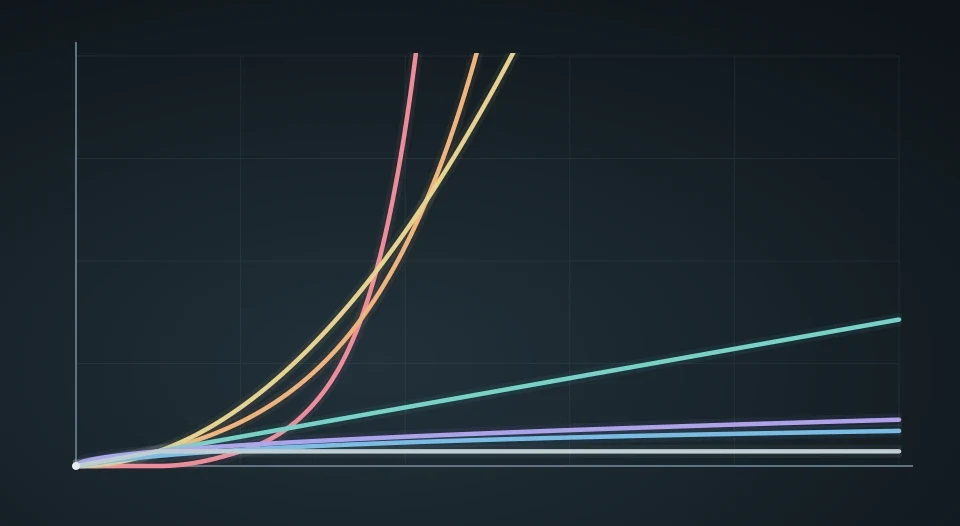
Las tres barras comparten una escala lineal de 0 a . Al cambiar , la escala se amplía con ellas; a la derecha aparecen los valores reales de las funciones. Una barra más corta también puede estar creciendo.
| n | ||||
|---|---|---|---|---|
| 4 | 2 | 4 | 16 | 16 |
| 8 | 3 | 8 | 64 | 256 |
| 16 | 4 | 16 | 256 | 65,536 |
| 32 | 5 | 32 | 1024 | 4,294,967,296 |
Para un trabajo polinómico con coeficientes fijos, el término de mayor grado acaba dominando el crecimiento. No tenemos que adivinarlo solo a partir de la gráfica. Por ejemplo, si el trabajo es , cuando se cumplen y ; entonces:
El multiplicador 20 permanece fijo, así que el trabajo es O(n²). Es la misma idea de crecimiento dominante que se estudia en Límites: crecimiento relativo. Las expresiones exponenciales, las potencias, las raíces y los logaritmos crecen a ritmos distintos. Comparamos su crecimiento para entradas grandes, no solo la inclinación de un tramo corto de la gráfica.
Comprueba lo que has entendido: duplicar el tamaño de la entrada
El crecimiento lineal se multiplica por 2; el cuadrático se multiplica por 4; log₂ n aumenta en 1. Estamos comparando funciones de crecimiento, sin prometer que el tiempo de ejecución de cada ordenador real cumpla exactamente esas proporciones.