GPU 怎样组织工作
假如一张图片太暗,我们想把它调亮。在问显卡怎样完成这件事之前,我们先弄清楚:电脑究竟为一张图片保存了什么?我们会跟随其中一小块,从看见的明暗走到要改动的数字,再回到实际执行工作的硬件。
从一幅图片开始
这一节一直使用同一小块图片。组成它的小格有不同的明暗,把每格的明暗记录成数字,就可以通过改动数字来改变图片。下面的演示会保留原图,让我们能把每次变化与起点作比较。
先找到图片中的小块
下面是一小块图片,有明的地方,也有暗的地方。这个例子只用黑、白和它们之间的灰色,不区分红、绿、蓝等颜色。这样的图叫灰度图。先只看明暗,就可以用一个数记录每一小块。
点“放大这块图片”。图中的内容不变,只把画法放大。接下来请找一找,组成这小块图片的方格。
逐步搭出保存数字的方法
我们不再看图片以后,电脑还需要留下记录。先取一个存储位置,让它有两种可以分辨的状态,分别记作 0 和 1。这样的一个位置叫一位,英文是 bit。0 和 1 是我们给状态写的记号,并不是机器里印着两个小数字。
一位只能留下两种不同记录:0 或 1。我们可以约定一种表示黑,另一种表示白,但这样就没有记录可用来区分中间的灰色了。想分清更多明暗,就需要更多不同记录。下面两种状态可以分别点击;选择“2 个存储位置”,就多了一处可以放 0 或 1 的位置,看看现在能组成多少种不同记录。
当前记录:0。一个位置给出两种选择。
改动一格,同时保留原值
现在,我们有了记录图片的数。为了让这个例子变亮,我们选择一条规则:每个数加 20;如果结果超过能保存的最大值 255,就保留为 255。把结果限制在允许范围内,叫限幅。这是本例选定的教学规则,不是对真实照片调亮过程的完整描述。
先读出原值 40。点“做加法”算出加 20 的结果,原值会保留下来。
把两个原值都试一次。它们遵守同一条规则,但只有 250 的加法结果需要被限制。处理整张图片,就要让每个像素都经历这次工作。这样,我们才有理由去找能够处理许多这类工作的硬件。
打开显卡看一看
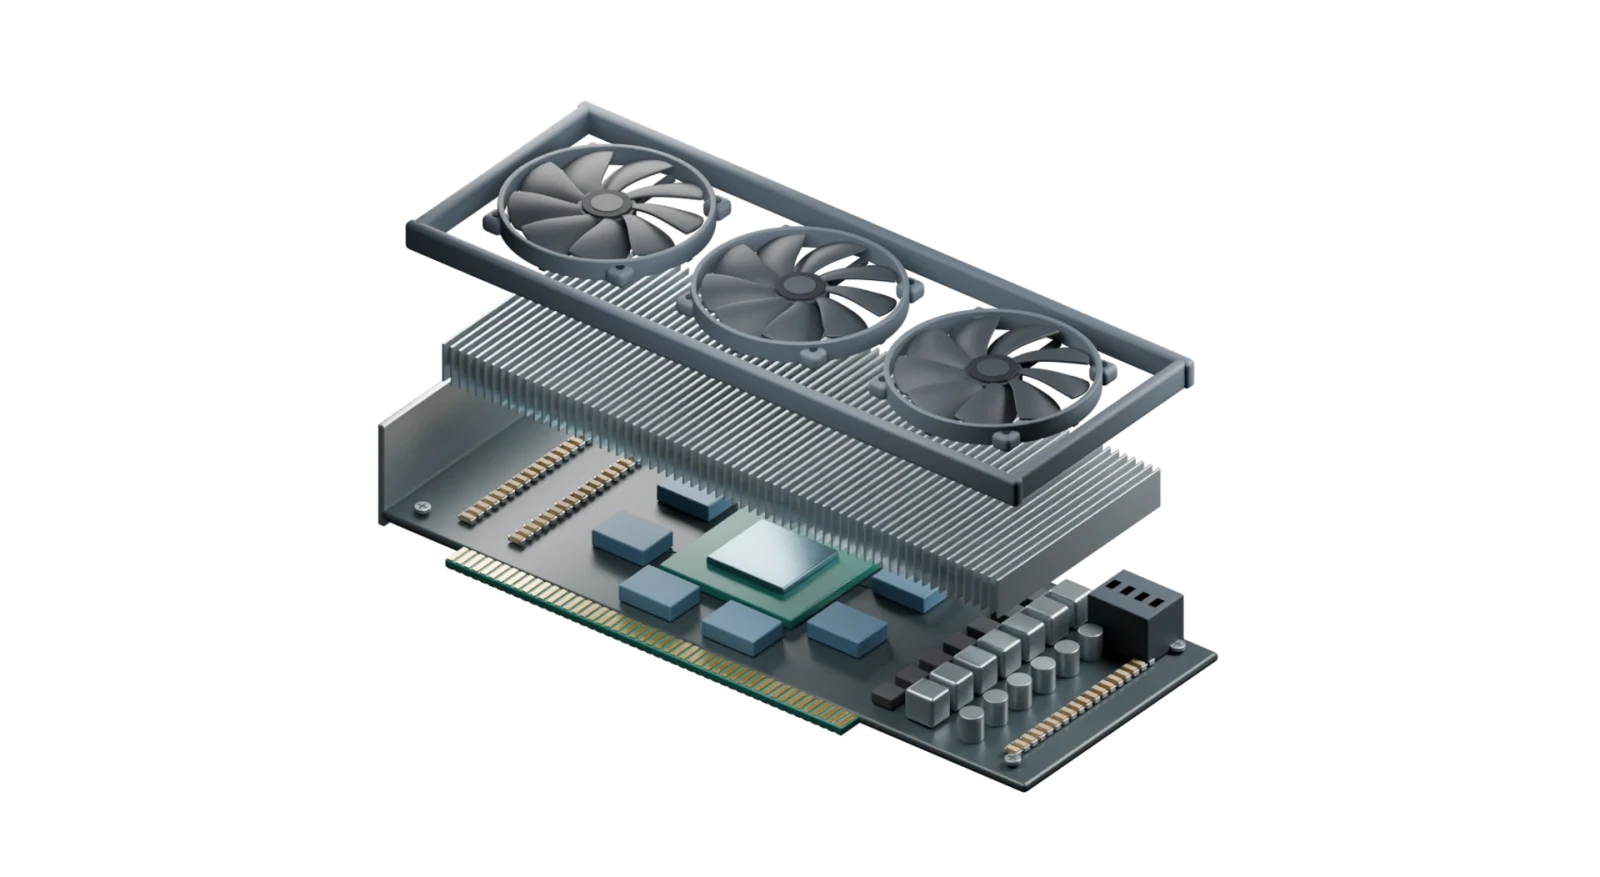
这些计算可以在哪里进行?独立显卡有处理芯片、附近的存储器、供电和散热部件。它们承担不同的工作:体积很大的风扇带走热量,芯片负责计算。在模型里找到这些部件,就知道各项工作发生在哪里。进入芯片后,我们还可以继续研究,修改图片的工作怎样被分配。
六个按钮对应同一张显卡的六组部件。我们先找芯片:带编号的标记和定位框指出选中的部件,旁边保留对应名称。可以聚焦这个部件,再回到整张显卡。抬起或暂时隐藏散热组件,可以看清下方的电路板。这些是方便观察的拆解视图,不是显卡工作时的样子。
GPU 芯片
小小的裸露方块是处理芯片。芯片内的电路执行指令、算出结果。GPU 是 graphics processing unit(图形处理器)的缩写,而整块板叫显卡。GPU 也可以集成在更大的处理器封装里,并不一定有独立显卡。
使用 Blender 制作的代表性独立显卡模型。它组合了可辨认的部件,不声称复现某个制造商的精确布线。芯片内部怎样组织,将在后面另行展开。
把同一批工作一起做
我们固定原来的十六个像素值。每个值都按同一规则处理:加二十,超过 255 就保留 255。一个工作位置,表示一个能够执行这次计算的地方;它不是图片中的坐标。先只用一个工作位置,因此一轮完成一个像素。另一组演示使用四个能力相同的位置,一轮就能分别完成四个不同的像素。
点“完成下一轮”,处理下一批尚未计算的像素。标着“原始输入”的图一直保留输入,“已保存的输出”接收答案。结果还空着,表示这格尚未处理;勾号指出最近一轮刚完成的格子。可以点任一图中的像素,在下方追踪它的数值。
角落的小数字是像素编号,大数字是灰度值。灰色块用来展示这些数值,不是经过校准的光强测量。
工作位置已经就绪
追踪像素 1
它的原值是 40。这一组还没处理到像素 1,因此尚无已保存的输出。它安排在第 1 轮,由工作位置 1 处理。继续推进,就能看到结果出现。
把两组记录放在一起比较
在一个位置和四个位置之间切换,会保留两组各自的进度。两组使用相同的十六个输入,也遵守相同的计算规则;改变的只有工作位置数量。把两组都做完,就能检查:轮数不同,答案是否仍然相同。
| 工作位置 | 已完成轮数 / 所需轮数 | 已完成像素 / 全部 |
|---|---|---|
| 1 | 0 / 16 | 0 / 16 |
| 4 | 0 / 4 | 0 / 16 |
一个位置要做十六轮,四个位置要做四轮。这样做之所以可行,是因为算第 2 个像素时,不需要先知道第 1 个像素的新值。我们没有缩短一次计算,而是安排不同的计算一起进行。播放时每轮留六秒,是方便观察,并非真实硬件的计时;也不能只凭这些轮数,保证实际 GPU 恰好快四倍。
逐项查看这一组已经完成的计算
目前还没有已完成的计算。请先在上方完成第一轮。
同时做工作,叫并行执行。吞吐量描述一定时间里完成多少工作,延迟描述一项任务从开始到完成等待多久。四个位置的例子缩短了这批独立像素的总完成时间,但没有说明每条指令本身的延迟都更低。CPU 也会使用并行;GPU 同样需要合适的工作、数据和指令,才能让资源持续忙起来。
进入处理器内部
程序是一串指令,指令就是读取数值、加二十等具体操作。线程是这些指令的一份执行过程,带着自己的工作数值。我们的像素例子可以给每个线程一个像素。接下来,GPU 芯片必须提供执行这些指令的位置:存储保存数值,控制选择发出哪条就绪指令,运算单元对数值做操作。下面画的是芯片内部的职责分工,不是上方金属方块的显微照片。
40 · 100 · 180 · 230
设备存储器 → 附近的缓存 → 寄存器
选择就绪工作,发出下一条指令
许多运算通道,按重复的组组织
| 像素 | 原始输入 | 寄存器副本 | 已发指令 | 计算结果 | 此刻设备存储 |
|---|---|---|---|---|---|
| 1 | 40 | 40 | — | — | 40 |
| 2 | 100 | 100 | — | — | 100 |
| 3 | 180 | 180 | — | — | 180 |
| 4 | 230 | 230 | — | — | 230 |
仍然使用刚才图片的前四格:40、100、180、230。还没相加时,这些数保存在设备存储器里。读取会把数复制到附近的小型工作存储位置,叫寄存器;读取不是把原来的数擦掉。下面每一行始终对应同一个像素编号。这一步只有输入和寄存器两列有数,结果还没有算出来。
缓存是附近的小型存储,保留一部分数据,减少重复进行较远的存储访问。有些架构还提供一小块由相互配合的一组线程显式共享的存储。具体大小、名称和组织方式会变化。以 NVIDIA 的术语为例,流式多处理器(SM)包含调度、运算与存储资源;warp 是由 32 个线程组成的调度组。我们把图里数量缩成四个,方便逐个观察,并不是说真实 warp 只有四个线程。
在 GPU 计算中,我们可以把某项操作需要的指令装进一个函数,也就是程序里有名称、完成一项任务的一段。kernel(核函数)就是一次启动、由许多线程执行的这种函数。对我们的例子,可以给每个线程分配一个像素,让它读取数值、加二十、写回结果。线程通常按组组织,便于硬件安排与共享资源。SIMT,即“单指令、多线程”,描述的是多个线程用各自的数据执行共同指令的这种方式。
哪些工作需要等待
像素例子能很好地一起做,是因为算一个答案时不必等另一个答案。有两类变化会让工作难以一直并排推进:后面的操作可能依赖前面的结果,或者同一组线程需要不同的指令路径。我们分别看清这两件事。
前后相依的一串结果
现在换一个任务。从 10 开始,加 3,再把答案作为下一次加法的输入。这一套写下来的步骤要求后一步读取前一步的结果。点“下一步”展开一个环节;多出来的工作位置不能跳过尚未得到的输入。
目前只有起始值 10 已经就绪。
这一串规则特别简单,我们可以改写算法,让每个位置直接计算自己的值,那就改变了工作的组织方式。这里要学会的是检查实际算法中的依赖,而不能假设多一些硬件就会自动消除依赖。
同一组需要不同指令时
现在使用新规则:小于 128 的值加亮 20,其余的值变暗 20。选择不同指令路径,叫分支。一组一起发出指令的工作,不能把两个不同操作当成同一条相同指令。在这个简化过程里,一条路径运行时,符合它的条件的通道工作,其他通道等待。换到另一条路径,刚才等待的通道才执行自己的操作。等待的通道保留自己的值,不会执行错误的规则。
这一组需要 2 条指令路径。不同线程选择了不同操作,因此需要两条路径,这种情况叫分支分歧。 模型数的是路径,不是硬件时钟周期;实际调度以及不同路径重新会合的方式依架构与程序而定。
存储访问也会让运算等待。数值还没有到,光有空闲运算单元是不够的。当一组等待时,调度器常能运行另一组已经就绪的工作,利用等待时间做别的事。不过这不会把原本的存储访问变成瞬间完成,也不能在没有就绪工作时凭空创造工作。
算上来回搬运的时间
使用独立 GPU 时,工作开始前,输入数据可能需要从电脑主存搬到设备存储器;完成后的结果也可能需要搬回来。搬运和准备都花时间。把还会重复使用的数据留在设备上,可以少走几次来回。集成 GPU 与统一内存系统的存储组织方式不同,但数据是否已经可用、需要怎样搬运,仍然重要。
这里虚构一个时间单位,表示一个工作位置完成一项工作所用的时间。两台教学机器的每个位置同样快,第一台只有一个位置,第二台有四个,但需要额外的准备与搬运时间。改变工作量,可以比较同一成本下谁更快;保持工作量不变,调整额外成本,就能单独检查成本的影响。这些是用来推理的假设,不是实测性能数据。
一个位置每单位时间完成一项,所以 16 项需要 16 个单位。四个位置每批完成四项互不依赖的工作,因此 批需要 4 个单位。最后加上额外成本: 个单位。在这个例子里,四个位置的机器更早完成。
工作项数量若不能被四整除,就会有一批装不满。例如十项可以装满两批,每批四项,共处理八项。剩下两项仍需要一批,所以一共三批。也就是把项数除以四后向上取整。第三批空出来的位置不会凭空多完成工作。
现在把前面的线索接起来:有足够多的合适工作、指令适合分组执行、数据搬运有效率时,GPU 才能持续利用许多执行资源。单看核心更多或显存容量更大,不能决定答案。真实比较需要测量实际任务,并计入相关搬运,而不能把教学图里的通道数量直接乘成保证的加速倍数。
从三角形到屏幕上的像素
照片的例子从已经存好的像素值开始。游戏常从更早的一步开始:物体表面用许多三角形描述。三个角点确定一个三角形,这些角点叫顶点。程序提供这些点和观察位置,GPU 把坐标转换到当前视图,再判断它们覆盖屏幕的哪些地方。
这里,三个顶点已经放到屏幕视图中。橙色边线把它们连成一个三角形。方格代表屏幕像素,我们把方格大幅放大,便于逐个查看。
点击一个像素,实际检查覆盖判断。以左上角为 (0, 0),向右量 x,向下量 y,单位是一格的宽度。三角形三个顶点是 (0, 0)、(6, 0)、(0, 6)。沿斜边每向右一格,y 就少一格,因此斜边满足 。中心点的和小于 6 时在内部;等于 6 时按本例事先约定的规则排除。
选中中心: (0.5, 0.5); 0.5 + 0.5 = 1 < 6. 在内部——第三步才填入颜色。
三维场景中,几个三角形可能落到同一个屏幕位置。深度值记录表面沿视线方向的远近,深度测试可以保留较近的可见表面,舍去被遮住的表面。实际渲染还要处理纹理、光照、透明和边缘。这个平面三角形只把其中一个必要环节分开看清:几何表面最终必须变成屏幕能够显示的数值。许多逐顶点、逐片元操作正好提供了适合 GPU 的重复工作。
再用一次这些想法
1. 十个互不依赖的像素,分给四个同样快的位置,需要几批?
查看推理
第一批完成四个,第二批再完成四个,剩下 。最后两个仍需要第三批,因此共三批。最后一批有两个位置没有工作。
2. 教学模型中,四项工作在一个位置上花四个时间单位;四个位置的机器算一批花一个单位,再加八个额外单位。哪台先完成?
查看推理
四个位置的总时间是 ,一个位置的总时间是 4,因此这里一个位置的机器先完成。并行计算省了三个单位,却多花了八个额外单位。这是在解释本模型的假设,不是一般性的 CPU/GPU 排名。
3. 为什么显存容量翻倍,不等于图像处理速度翻倍?
查看推理
容量告诉我们能装下多少数据。如果原来的空间已经够用,更多空间可能不改变这次计算。速度还可能受运算能力、指令依赖、搬运或显存带宽限制,需要先找出这个任务真正被哪一项限制。