生物学 · 分子结构
DNA、RNA 与遗传信息
皮肤上的小伤口能够愈合,是因为细胞会制造新的材料,并在适当条件下分裂。但新细胞怎样得到自己需要的信息?细胞又怎样利用保存的信息,做出真正能工作的东西?这是两个不同的问题。复制 DNA 回答前一个问题;RNA 与蛋白质的制造过程帮助我们回答后一个问题。
如果 DNA、基因、RNA 听起来已经像一串要背的名字,可以先把这串名字放一放。我们手里其实只有两个具体问题:信息怎样传下去,又怎样被利用。接下来从一个细胞走到其中选出的一段 DNA 时,我们会一直带着这两个问题。基因、核苷酸、核糖体各自做什么,等例子用到它时再解释,含义也会留在模型旁边。
本课主要以具有细胞核的人体细胞为背景。分子的形状、间距、颜色与教学序列经过简化;它们不是活细胞的实时录像,也不是原子结构测量结果。
1. 从一个需要工作的细胞开始
你的身体由许多细胞组成。细胞是一个小的生命单位。细胞膜把内部与周围环境隔开,也调节物质进出,并不是任何东西都过不去的实心墙。细胞内部,分子参与制造新材料、释放可利用能量,也有分子帮助搬运物质。分子是一群连接在一起的原子;原子是构成物质的很小单位,原子重新组合就形成不同的化学物质。这一章先跟着三样东西走:细胞、细胞膜,以及细胞里做这些工作的分子。
完成这些工作的分子中,很多是蛋白质。蛋白质含有一条或多条氨基酸链;氨基酸是构成这些链的小分子单位。单位的排列顺序会影响链怎样折叠,以及蛋白质能做什么。因此,只有原料还不够:细胞还需要一种办法,确定这些原料应该怎样排列。
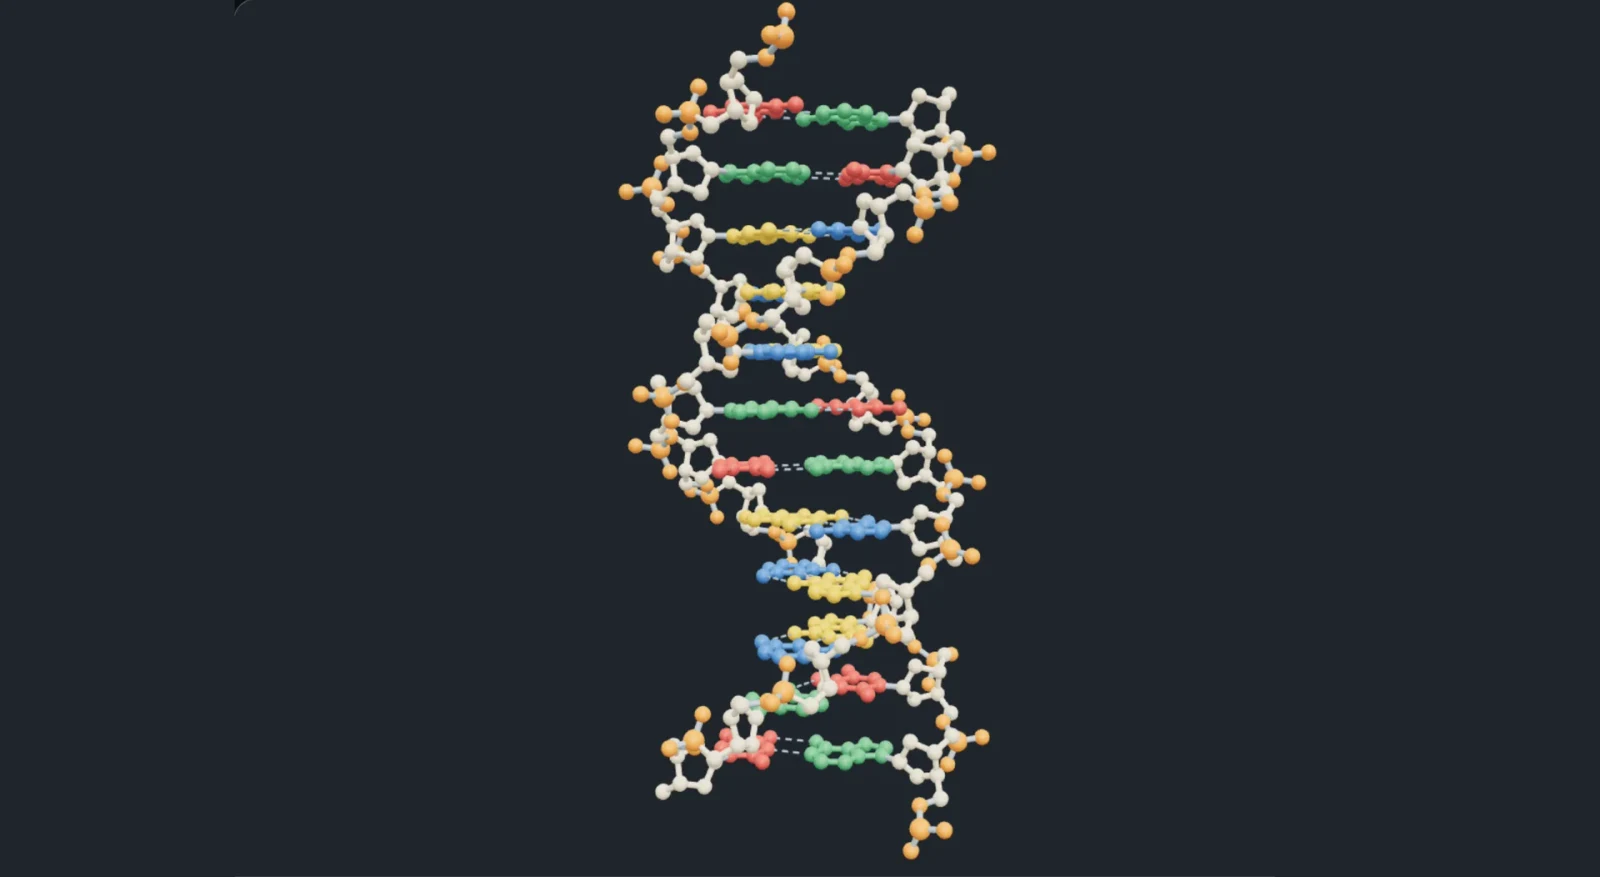
刚才说,细胞需要保留下来的是一种排列顺序,这就把我们带到了 DNA。它的中文名称是脱氧核糖核酸,是一种保存生物序列信息的化学物质。“信息”现在可能仍有些抽象,后面我们会沿着组成单位的顺序,看其他分子怎样利用它;眼下先找到这份材料。下面人体细胞模型中的大部分 DNA 位于细胞核,也就是有自己的膜包围的区域。线粒体也含少量 DNA;这个例子追踪的是细胞核里的那一份。
2. 追踪同一份材料,不丢掉它原来的位置
把很小的结构放大以后,细节变清楚了,却也容易冒出一个新疑问:“我现在看的,还是刚才那一段吗?”细胞与 DNA 分子的大小相差太多,我们需要分几次放大。因此,按“下一步”前,请找到橙色选区。视角会变,橙色却始终帮我们认住同一份选中的材料。如果新画面让你有些找不到位置,可以看一眼下方的小图,它替我们保留着原来的位置。
细胞核里面的紫色丝状物表示染色质。染色质指 DNA 与参与组织它的相关蛋白质。橙色部分就是从这批紫色丝状物中选出的一段。后面看清 DNA 与供它缠绕的蛋白质,是在揭示染色质本身的组成,不是在里面发现一种无关的第二种材料。
紫色=染色质。橙色=同一批染色质中选出的一小段。
细胞与细胞核
我们先看一个简化的动物细胞。外面的绿色边界是细胞膜;里面较小的紫色区域是细胞核。为了让你看见内部,我们把细胞膜和核膜的前半部分切开了。真实细胞并没有这些敞开的切面。
先找到紫色细胞核里面标成橙色的一小段。接下来,我们会始终追踪这一段。
再回头看那个缠绕单位,它叫核小体:DNA 绕在由八个组蛋白组成的核心上。组蛋白是一类蛋白质,不是 DNA 的另一个名字。许多这样的单位帮助组织一条很长的 DNA 分子。模型把单位之间的距离拉开,是为了让连接看得清;细胞内的染色质并不总是一根均匀、规则盘绕的纤维。
DNA 和染色体也不能随意当作同一个词。染色体是这种 DNA—蛋白质材料经过组织形成的一个单位。复制前,一条人的核染色体包含一个很长的双链 DNA 分子及相关蛋白质。即使它伸展开、在显微镜下不容易分辨,它仍然是染色体,不必长成 X 形才算。
3. 为什么一个 X 里面有两个 DNA 分子
为了把数量讲清楚,我们选一个具有两套染色体的典型人体细胞:来自父母各一套,每套 23 条,合计 46 条。这是本课的例子,不是说所有人体细胞都一样。卵细胞和精子通常各有 23 条;成熟的人体红细胞没有细胞核。某些其他特化细胞也不符合这个例子。
在一次普通细胞分裂之前,每个 DNA 分子先被复制。两份副本分别位于两条姐妹染色单体中,并暂时保持相连。染色单体就是这样的 DNA 与蛋白质副本。姐妹染色单体在分开前保持结合;X 形图中央收窄、称为着丝粒的区域,是我们熟悉的连接区域。每条姐妹染色单体都含有一个完整的双链 DNA 分子。所以,X 的两半并不是一个 DNA 双螺旋的两条链。
姐妹染色单体还连接着时,着丝粒把它们连在一起,仍是一个整体,所以这一对算作一条已复制的染色体。DNA 的量已经加倍,染色体计数却还没有随之加倍。姐妹分开后,每一条才分别算作一条染色体。在普通的分裂中,两个子细胞各得到每条染色体的一份副本。
先追踪其中一条染色体
1 条染色体 · 1 个 DNA 分子
粗线表示一个 DNA—蛋白质单位,是一整条染色体的示意,不是一个 DNA 分子中的一条链。
上面的示意图只跟踪一条染色体。要看到全部染色体,可以回到第 2 章的三维模型,按“比较细胞分裂时的染色体”:那个分裂视图展示 46 条已复制的染色体,共含 92 个 DNA 分子。它们被拉开、排放,便于观察数量;这不是它们在活细胞中的随机位置,也不是中期赤道板。这里的 X 形表示凝缩的、已复制的染色体,不表示它们全都是名叫 X 的性染色体。核膜解体和染色体凝缩也有过程,并不是一按开关就在同一瞬间全部完成。
4. 一条 DNA 链怎样配上另一条
现在回到 DNA 分子本身。物质由原子构成,化学键可以把原子连接成分子。核苷酸是 DNA 链的一个重复单位,包含三个相连的部分:磷酸基团、叫脱氧核糖的糖,以及一个碱基。这里的“碱基”只是核苷酸的一部分,不能用它代指整个核苷酸。
DNA 常见的四种碱基是腺嘌呤 A、胸腺嘧啶 T、鸟嘌呤 G 和胞嘧啶 C。我们使用字母,是因为追踪十二个字母比追踪十二个很长的化学名称容易。糖与磷酸反复连接,构成链的骨架;每个糖还连接着一个碱基。换一个字母,改变的是碱基,不是把整条骨架的基本连接方式都换掉。
在第一条链旁边放上第二条链。DNA 通常按 A 配 T、G 配 C 的规则配对。这样的互补配对有相容的形状与原子排列,可以形成氢键。氢键是特定原子基团之间的吸引作用,与维持每条链骨架连接的共价键不同。
一个核苷酸
核苷酸是组成 DNA 链的一个基本单位。橙色表示磷酸基团,米色表示称为脱氧核糖的糖,绿色表示碱基 A。实心棍表示连接原子的共价键。点击一种组成部分,其他部分会变淡;再拖动或重置视角,观察这个立体结构。
小球是表示原子的绘图方式,不是原子的真实表面。大多数氢原子没有画出,以免遮挡我们要观察的键。
A—T 通常形成两个氢键,G—C 形成三个。不过,如果说 DNA 的形状只靠氢键维持,就不完整了。相邻的碱基还在螺旋内部彼此堆叠,这些堆叠相互作用也对稳定结构有重要贡献。看模型时,既要横着看一对碱基,也要沿着螺旋看相邻碱基的堆叠。
分子的某些部分本来就近似平面,例如这些碱基的环状部分;另一些部分则向三维空间伸展。准确的模型应同时保留这两件事。拖动核苷酸,看看折起的糖环与立体的磷酸基团,再与碱基环比较。球和棍只是表示原子、化学键的绘图约定,不是它们表面的照片。
5. 一个序列还需要说明方向
每个核苷酸的糖里面,碳原子有编号。 和 指其中两个位置,分别读作“五撇”和“三撇”。相邻核苷酸通过磷酸连接:一个糖的 位置与下一个糖的 位置相连。因此,一条链的两个末端有不同的化学性质。撇号用来区分糖上的原子编号,不表示导数、时间或长度。
DNA 的两条链方向相反。如果上面一条从左侧的 通向右侧的 ,下面的伙伴就从左侧的 通向右侧的 。这叫反向平行,说的是两条链的化学朝向,不是说它们正在往相反的方向移动。
现在使用结构模型中的同样十二个位置。在每个位置,选择应当放在已有碱基正下方的伙伴。从位置 1 开始:上方是 ,下方就应是 。位置 2 上方是 ,下方就应是 。我们是在从左到右记录相对的位置,还没有把下面那条链改写成它自身的 到 阅读顺序。
逐个位置,补出互补链
选中一个编号的位置,下方的 A、T、G、C 就可以用来更改这个位置的碱基。突出显示的一列,是互相面对的两个碱基。
位置 1 上方的 A 应当配什么?
已填好 0/12 个伙伴位置。两条链仍各自保留原来的化学方向。
单独写一条 DNA 序列时,通常按 到 的方向写。找到互补链,就是在每个位置选出配对的碱基。这样确定了碱基,但图上显示的顺序可能是 到 。如果要按 到 书写,就需要把显示顺序反过来。以这十二个位置为例,下方伙伴从左到右是 3′–TACGCATGCGAT–5′;从第 12 位往回念,就是 5′–TAGCGTACGCAT–3′。改变的是书写方向,分子本身没有改变。
6. DNA 含有信息,具体是什么意思?
糖—磷酸的框架不断重复,但碱基顺序可以变化。ATG 和 AGT 含有相同的三个字母,排列却不同。与这些片段相互作用的分子能够区分这种顺序。因此,序列会影响细胞制造什么,以及在什么时候制造。这里的信息指一种能通过分子相互作用被复制、被利用的排列;不是说字母自己懂得含义。
基因是一段用于制造有功能的 RNA 的 DNA 序列。有些 RNA 携带制造蛋白质的指令,细胞读取其中相应的部分,确定要用哪些氨基酸。另一些 RNA 本身就在细胞里承担工作,并不用于制造蛋白质。稍后会遇到的 tRNA 和 rRNA 就是例子。所以,说“每个基因都制造蛋白质”会漏掉重要的一类基因。
也不是每一段 DNA 都编码蛋白质。有些区域帮助调节基因在什么时候被使用;有些承担结构或其他作用,还有一些区域的作用尚未完全了解。一个生物的全部 DNA 称为基因组。一条染色体是这个集合中经过组织的一部分,不是一个基因;沿着一条染色体可以分布许多基因和其他序列。
上面的十二碱基例子是为了练习结构和配对而设计的,不是一整个能工作的真实人体基因。仅仅含有 A、T、G、C,甚至含有某个熟悉的短序列,也不足以构成带有全部必要使用信号的完整基因。
只有四种字母,为什么能有那么多不同序列?
一个位置有四种选择:A、T、G、C。再加第二个位置。对第一位的每一种选择,第二位都有四种选择:选了 A 后,可以组成 AA、AT、AG、AC;T、G、C 后也各有四种选择。因此是四组四种,合计 16 个两字母序列。
AA AT AG ACTA TT TG TCGA GT GG GCCA CT CG CC第三个位置又给每个两字母序列增加四种延长方式,因此数量变成 。以后每增加一位,就再乘一次 。把这种重复相乘写成幂, 个位置就有 个序列。这里 数的是位置,不是染色体或氨基酸。
A T G C4 种选择A T G C4 种选择A T G C4 种选择7. 复制 DNA,同时追踪旧链去了哪里
回到最初的问题:两个子细胞怎样都得到 DNA 信息?如果只是把一个分子剪成两半,每个细胞就只得到其中一部分序列。因此,细胞在分裂前要制造副本。把 DNA 复制成 DNA 的过程,叫 DNA 复制。
互补配对提供了一个办法。把两条链分开,但不切断任何一条骨架。每个露出的旧碱基,就限定了旁边应当放什么新碱基:旧 A 对应新 T,旧 T 对应新 A,G 与 C 也互相对应。旧链充当模板,也就是用来决定新序列的已有序列。
模型用紫色骨架标记原来已有的材料,用蓝色骨架标记新制造的材料;碱基颜色仍然区分 A、T、G、C。请把两条旧链都追踪到最后。不要因为说“得到两个新的 DNA 分子”,就以为两个产物中的每个原子都必须是新的。
旧5′ ATGCGTACGCTA 3′
新3′ ············ 5′
旧3′ TACGCATGCGAT 5′
新5′ ············ 3′
初始立体视角中,位置从下往上排列;字母行把同样的位置从左往右写出。点表示暂未补出的新核苷酸。字母行用来比较配对,不表示合成方向。
播放时每步保留九秒。需要更多时间时,可以暂停,或自行点击下一步。
从一段双链 DNA 开始
细胞分裂前,需要先复制 DNA。这里只追踪十二对碱基,不表示一整条染色体。两条骨架都用紫色,因为它们都是原有的旧链;碱基颜色仍然表示 A、T、G、C。下方的字母行始终记录同样的十二个位置。
一个 DNA 分子有两条链。接下来分子数变化时,要始终分清“一个分子”和“一条链”。
最后,每个双螺旋都包含一条旧链和一条新链。这就是半保留复制:每个产物的两条链中,有一条来自原来的分子。旧链提供顺序依据,游离的核苷酸提供新材料。旧碱基并没有分裂成两份,也没有变成新链。
真实细胞不能只靠一条配对规则工作。这一段和下一段是补充细节,第一次读可以先跳过。解旋酶是一种帮助局部打开双链的分子机器。DNA 聚合酶则是把合适的核苷酸添加到生长中 DNA 链上的酶。酶是帮助化学反应进行的分子,许多酶是蛋白质。DNA 聚合酶需要已有的起始末端,这由一小段引物提供;它把新单位接到新链的 端。因此,新 DNA 沿 到 方向增长。
旧 DNA 上打开的区域会继续推进,分叉的末端叫复制叉。旧链的朝向相反,两条新链不能朝同一个方向延长。一条沿着复制叉推进的方向延长;另一条分成短段,各段朝远离复制叉的方向生长。每个短段仍然都是 到 合成。引物被移除并用 DNA 补上后,DNA 连接酶封闭剩余的骨架断口,最后得到连续的链;不是第二条链倒着合成。
这个动画专门把配对与旧材料的去向讲清。展开成直梯、同时补上对应位置,都是展示选择,不是这些酶的完整时序图。模型还假定复制正确。细胞有校对和修复机制,但错误有时仍会留下;DNA 序列发生的改变称为突变。
8. 一种副本用于传下去,一种副本用于使用
现在可以分清两个看起来容易混淆的过程。复制把 DNA 复制成 DNA,使基因组能够在分裂时传下去。转录则以选定的一段 DNA 为模板,制造 RNA。对某一个 RNA 产物,转录读取两条 DNA 链中的一条,原来的 DNA 仍然保留。
RNA 叫核糖核酸。它也由核苷酸组成,不过糖是核糖,不是脱氧核糖;常见碱基是 A、U、G、C。U 叫尿嘧啶。转录时,DNA 模板上的 A 配来的是 RNA 的 U;如果在复制 DNA,同样的位置则配 T。RNA 通常是单链,但同一条链的不同部分可以互相配对,折成三维形状。
翻译又是第三个过程:利用 mRNA 的序列组装氨基酸链。mRNA 的名称是信使 RNA。信息链提供顺序,氨基酸提供新链的材料;不是 mRNA 自己变成了蛋白质。接下来,我们会分别观察 RNA 信息链、搬运氨基酸的 tRNA,以及组装链的核糖体内部所含的 rRNA。
复制
为细胞分裂保存基因组
每条旧链各作为模板,配出一条新的 DNA 伙伴。
转录
产生供使用的 RNA
选定的一条 DNA 链作为模板,决定一条 RNA 的序列。
翻译
组装氨基酸链
核糖体与 tRNA 利用密码子,RNA 本身仍是 RNA。
箭头表示利用信息、以新材料制造产物,不表示左边的分子直接变成了右边的分子。
9. 跟着三种 RNA,看看它们各自怎样工作
进入下面的工作台时,我们特意换一个短例子。前面的 ATGCGTACGCTA 用于练习 DNA 配对;这里经过 RNA 加工后,信息是 AUG GCU UUU UAA。这样可以完整追踪三个氨基酸和一个终止信号,不必把步骤藏在很长的序列里。这是两个独立的教学例子,不是同一个分子变化前后的状态。
下面的讲解说明蛋白质与 RNA 是什么。带着这些对象,我们就能看懂 mRNA、tRNA、rRNA 和组装循环分别在做什么。每章都有稳定的视角;“播放”只演示当前一步,结束后停下来,由你按“下一步”决定何时继续。只有想检查结构时才需要旋转或缩放;找不到位置时,用“恢复视角”回到本章的观察位置。
细胞怎样使用 DNA 中的信息
DNA 的顺序还不是能工作的蛋白质
细胞不只是保存 DNA。它还需要搬运物质、支撑自己的形状,并完成各种化学反应。完成这些工作的分子中,很多是蛋白质。例如,血红蛋白帮助我们的血液运输氧气;许多酶也是蛋白质,它们帮助特定的化学反应以细胞所需的速度进行。
蛋白质含有一条或多条由小分子连接成的链,这些小分子叫氨基酸。氨基酸不是 DNA 的碱基。下面用琥珀色小球表示氨基酸,用带字母的彩色单位表示 RNA 的碱基,便于你始终分清这两种东西。氨基酸的排列顺序会影响链怎样折叠、能做什么。有些链还需要进一步加工,或与其他链结合后才能工作。
于是问题具体了:DNA 保存的是碱基的排列顺序,蛋白质需要的却是氨基酸的排列顺序。细胞怎样利用前一种顺序,组装出后一种顺序?我们会一直使用同一个特意缩短的例子:AUG、GCU、UUU、UAA。它会产生含三个氨基酸的小链,随后遇到停止指令。这条极短的小链不是一种能工作的真实人体蛋白质。
先认识这种材料:RNA
RNA 和 DNA 一样,也是一串核苷酸。RNA 的每个核苷酸都包含磷酸基团、一种叫核糖的糖,以及一个碱基。它常见的碱基是 A、U、G、C。U 代表尿嘧啶;在相应序列中,RNA 用 U,而 DNA 用 T。RNA 通常只有一条链,但同一条链的不同部分可以互相配对,使它折叠。因此,“单链”不等于一根笔直、僵硬的线。
RNA 链的两端在化学结构上不同。我们把两端标为 和 ,分别读作“五端”和“三端”;这些名称来自糖分子中碳原子的编号。它们表示方向,不表示有五个或三个碱基。合成新的 RNA 时,核苷酸接到已有链的 端,所以我们把合成方向写成从 到 。下面每条字母序列都会明确标出方向。
mRNA、tRNA 和 rRNA 是不同 RNA 分子按工作角色得到的名称。信使 RNA(mRNA)携带需要读取的序列;转运 RNA(tRNA)把能配对的三个碱基与一种氨基酸联系起来;核糖体 RNA(rRNA)参与构成读取信息、连接氨基酸的结构。它们不是同一条链先后变成的三个形态:mRNA 不会先变成 tRNA,再变成 rRNA。
那么 tRNA 和 rRNA 又从哪里来呢?它们同样由 DNA 转录产生,再经过加工。它们最终发挥作用的产物就是折叠的 RNA 分子本身,而不是读取它们的碱基后制造出来的蛋白质链。因此,基因既可以产生有功能的 RNA,也可以产生供制造蛋白质使用的 RNA 信息。接下来选择的“蛋白质编码基因”属于后一种情况。
mRNA:制作并运送一份工作副本
我们以有细胞核的人体细胞为例。蛋白质编码基因是 DNA 上的一段区域,它的序列可以用来产生 RNA,而这种 RNA 能指导蛋白质的制造。DNA 留在细胞核里,细胞另外合成一份 RNA 副本。这个复制信息的过程叫转录。最初的副本还可能需要加工,才成为能在细胞核外被读取的成熟 mRNA。
先看从 写向 的 DNA 模板链。RNA 聚合酶是一种沿着模板移动、合成 RNA 链的酶。每读到一个模板碱基,它就接入能与之配对的 RNA 碱基:DNA 的 对应 RNA 的 , 对应 , 对应 , 对应 。因此,模板上的 TAC 会得到 RNA 上的 AUG。RNA 与这条模板的序列互补;它不是从 DNA 中抽出一条旧链,再改个名字。
下方的序列条中,没有阴影的两段会被保留,灰色条纹区段是加工时会被去掉的一段。保留的区段叫外显子,去掉的区段叫内含子。有些外显子还包含不被翻译的序列,因此,“外显子”不等于“其中每个碱基都用于制造氨基酸”。为了看清主要过程,这个彩色编码例子省略了不被翻译的两端,并使用一段特意缩短的虚构内含子。
选择一个编号步骤,再播放这一步。到达该步终点时会自动停下,方便你检查。轻轻拖动可以转动模型,也可以点击“恢复视角”。点击“放大”可以检查连接处,“恢复视角”则重新显示整个操作。摄像机不会追着分子移动;下方的序列条会在你转动模型时,始终保留可读的方向与字母。
上面是编码链,下面是模板链。为便于检查,图中把这一小段拉直并分开了;真实转录只会局部打开 DNA。两条链的方向相反。从左向右看下面的 TAC;新 RNA 会以 AUG 开始。
始终看清字母的对应关系
条纹 GUACAG 区段是虚构的内含子。去掉这六个字母后,AUGGCU 与 UUUUAA 接在一起,两段保留序列原来的先后顺序。
回到最初的问题。DNA 的信息先被转录到另一条 RNA 分子上,加工后得到成熟 mRNA。装载了氨基酸的 tRNA 与先后的密码子配对并提供氨基酸。由 rRNA 和蛋白质组成的核糖体把这些分子放在适当位置,并帮助连接氨基酸。信息链用于确定顺序,并不是作为蛋白质的原料被消耗掉。
模型把活细胞中可能重叠发生的事件拆开了,也省略了许多辅助蛋白质、能量转移和检查步骤。mRNA 被拉直,是为了让你读清顺序。三维分子形状是用 Blender 制作的原创教学模型,不是实验测得的原子结构。转动模型有助于检查连接关系,但显示出的大小、颜色和运动速度都不是测量结果。
检查这些关系是否接通了
模板以 开始,为什么 RNA 以 开始?
按所标方向读取模板。T 配 RNA 的 A,A 配 RNA 的 U,C 配 RNA 的 G。新链朝自己的 3′ 端延长,方向与模板相反,因此得到 5′–AUG–3′。这里用的是互补配对,不是把每个 DNA 字母照写成相同的 RNA 字母。
第一次肽链转移完成时,哪一个 tRNA 携带 Met–Ala?
A 位点的 tRNA 携带连接后的链。转移前,P 带 Met,A 带 Ala;形成新键时,已有部分转接到 A 位点所连接的氨基酸上,所以 P 位点的 tRNA 变空。下一次移动后,携带链的这个 tRNA 才相对于核糖体进入 P 位点。
UAA 会加入第四个氨基酸吗?mRNA 会变成蛋白质吗?
两者都不会。UAA 是在释放因子帮助下识别的终止指令;在这个标准密码的例子中,它不添加氨基酸。蛋白质链的材料来自 tRNA 带来的氨基酸,mRNA 提供添加顺序,本身仍然是 RNA。
科学资料:NHGRI · RNA · NHGRI · tRNA · Molecular Biology of the Cell · From RNA to Protein
10. 改动序列,追踪结果怎样变化
现在可以具体检查:碱基顺序改变了什么?我们继续用 RNA 工作台的短信息 AUG GCU UUU UAA。这里列出对应的编码 DNA 链:。编码链与 RNA 的序列对应,只是 DNA 使用 ,RNA 的对应位置使用 。转录时充当模板的是对面的另一条 DNA 链。
密码子是在确定阅读框内读取的三个 RNA 碱基。阅读框说明从哪里开始每三个分一组。这个虚构例子把第一个 AUG 固定为起点,然后连续分组,不跳过字母,也不让相邻组重叠。标准遗传密码把每组对应到一种氨基酸或终止信号;同一种氨基酸可以由不止一种密码子指定。
可以选择一个例子,也可以修改下面编码 DNA 的某个字母。碱基替换是把一个字母换成另一个,字母总数不变。相对的模板与产生的 RNA 会跟着更新。请沿着一列往下看:DNA 序列、RNA 密码子,然后是对应氨基酸。遇到第一个终止密码子后,后续分组仍在信息链上,但不会继续加到这条氨基酸链上。
同一条信息,直接比较四种结果
编码 DNA 与 RNA 都从左侧 通向右侧 ;对齐的模板则从左侧 通向右侧 。用每个字母的菜单可以修改 DNA;起始的三个字母保持固定。
第 1 组
编码 DNA模板 DNATACRNAAUG对这条链的贡献Met · 甲硫氨酸第 2 组
编码 DNA模板 DNACGARNAGCU对这条链的贡献Ala · 丙氨酸第 3 组
编码 DNA模板 DNAAAARNAUUU对这条链的贡献Phe · 苯丙氨酸第 4 组
编码 DNA模板 DNAATTRNAUAA对这条链的贡献停止,不添加氨基酸改变的位置数: 0 · 氨基酸链: Met — Ala — Phe
AUG、GCU、UUU 产生 **Met—Ala—Phe**;UAA 使读取停止,不提供氨基酸。
同义改变表示在这个阅读框中,氨基酸序列没有改变。这不等于已经证明它在活细胞里完全没有影响:RNA 的加工、稳定性或翻译过程也可能受到影响。换了一个氨基酸同样不能直接证明会引起疾病。这个小模型只报告在指定起点与阅读框下的序列结果,不预测人的健康。
11. 用自己的话,把整条过程连起来
回到开头的细胞。紫色染色质是 DNA 与蛋白质共同组成的材料;DNA 的碱基排成序列,互补配对让这个序列能够被复制,复制的每个产物各保留一条旧链。选定的一段 DNA 也可以被转录成 RNA。有些 RNA 携带信息,另一些充当适配器,或构成利用信息的机器的一部分。
试着回答下面的问题,解释可以展开查看。回答时可以说清楚:有哪些材料,什么发生了变化,什么保留下来。过程的名称能帮助我们称呼它,但还没有说明它是怎样发生的。
选中的 DNA,是藏在染色质里面的一根无关的线吗?
不是。染色质本来就指 DNA 与相关蛋白质。放大选中的部分,是为了区分这些组成。橙色选区与先前紫色丝状物指向同一份材料,只是观察方式不同;颜色是教学标记。
一个细胞有 46 条已复制、姐妹尚未分开的染色体,核 DNA 分子有多少个?
每条已复制的染色体有两条姐妹染色单体,每条染色单体有一个双链 DNA 分子,所以核 DNA 分子有 个。在这个阶段,仍然是 46 条已复制的染色体。如果数单条链,则是 条;这又是另一种计数对象。
复制后,会不会一个产物全旧、另一个产物全新?
不会。原来的两条链分别作为模板,各配出一条新伙伴。产物分别是“旧链 1 加上它的新伙伴”和“旧链 2 加上它的新伙伴”。每个产物都是一旧一新。旧材料分到了两个产物中,并没有全部留在其中一个。
模板写作 ,对应制造什么 RNA?这一步已经做出蛋白质了吗?
逐个位置使用 RNA 配对规则:T 对应 A,A 对应 U,C 对应 G,所以 RNA 为 5′—AUG—3′。这是转录,产物是核苷酸链,还没有组装氨基酸链。在适当的翻译环境中,AUG 可以作为起始密码子,但只有这三个字母并不构成完整的功能基因或蛋白质。
肽链转移后,哪条 tRNA 仍连着氨基酸链?到 UAA 时又发生什么?
已有的链从 P 位点 tRNA 转接到 A 位点 tRNA 携带的氨基酸上。旧 tRNA 不再带氨基酸,离开时不会把完成的链带走。随后 UAA 进入 A 位点,发出终止信号。帮助释放链的是释放因子,不是一个携带氨基酸的 tRNA。在我们的三氨基酸例子里,UAA 不会增加第四个氨基酸。