Cómo organiza el trabajo una GPU
Supongamos que una imagen se ve demasiado oscura y queremos aclararla. Antes de preguntar cómo lo hace una tarjeta gráfica, averigüemos qué guarda el ordenador de una imagen. Seguiremos un pequeño fragmento, desde su aspecto visible hasta los números que cambiamos, y volveremos al hardware que hace el trabajo.
Empezar con una imagen
En toda esta sección usaremos la misma pequeña zona de imagen. Sus celdas tienen distintos niveles de luminosidad. Registrar la luminosidad de cada celda como un número nos permite cambiar la imagen cambiando un número. El fragmento original permanece visible abajo, para comparar cada cambio con el punto de partida.
Primero, encuentra las pequeñas partes de una imagen
Aquí hay una pequeña parte de una imagen. Tiene zonas claras y zonas oscuras. Este ejemplo usa solo negro, blanco y los grises intermedios, sin distinguir colores como el rojo, el verde o el azul. A una imagen así la llamamos imagen en escala de grises. Si miramos solo las luces y las sombras, podemos empezar por registrar cada pequeña parte con un solo número.
Selecciona “Ampliar este fragmento”. El contenido no cambia; solo se agranda la forma de dibujarlo. Ahora busca los cuadraditos que forman este fragmento.
Construir poco a poco una forma de guardar un número
Cuando dejamos de mirar la imagen, el ordenador todavía necesita conservar un registro. Empecemos con una posición de almacenamiento que pueda estar en dos estados distinguibles, que escribimos como 0 y 1. Esa única posición se llama bit. Los 0 y 1 escritos son nuestras marcas para los estados; no son dos números pequeños impresos dentro de la máquina.
Un bit solo permite dos registros distintos: 0 o 1. Podríamos acordar que uno represente el negro y el otro el blanco, pero entonces no quedaría ningún registro para distinguir un gris intermedio. Para distinguir más niveles de claridad necesitamos más registros distintos. Puedes pulsar los dos estados de abajo. Si eliges “2 posiciones de almacenamiento”, tendrás un lugar más donde poner un 0 o un 1; observa cuántos registros distintos se pueden formar ahora.
Registro actual: 0. Una posición ofrece dos posibilidades.
Cambiar un píxel y conservar el original
Ya tenemos los números que registran la imagen. Para aclarar este ejemplo, elegimos una regla: sumar 20 a cada valor y, si el resultado supera el máximo que se puede guardar, 255, conservar 255. Limitar el resultado al rango permitido se llama recorte. Es una regla elegida para este ejemplo didáctico, no una descripción completa del proceso de aclarar una fotografía real.
Primero leemos el valor original 40. Pulsa «Hacer la suma» para calcular el resultado de sumar 20; el valor original se conservará.
Prueba los dos valores originales. Ambos siguen la misma regla, pero solo la suma de 250 necesita el paso de limitación. Procesar una imagen completa exige repetir este trabajo para cada píxel. Por eso tiene sentido buscar hardware capaz de realizar muchas de estas tareas.
Abrir la tarjeta gráfica y mirar dentro
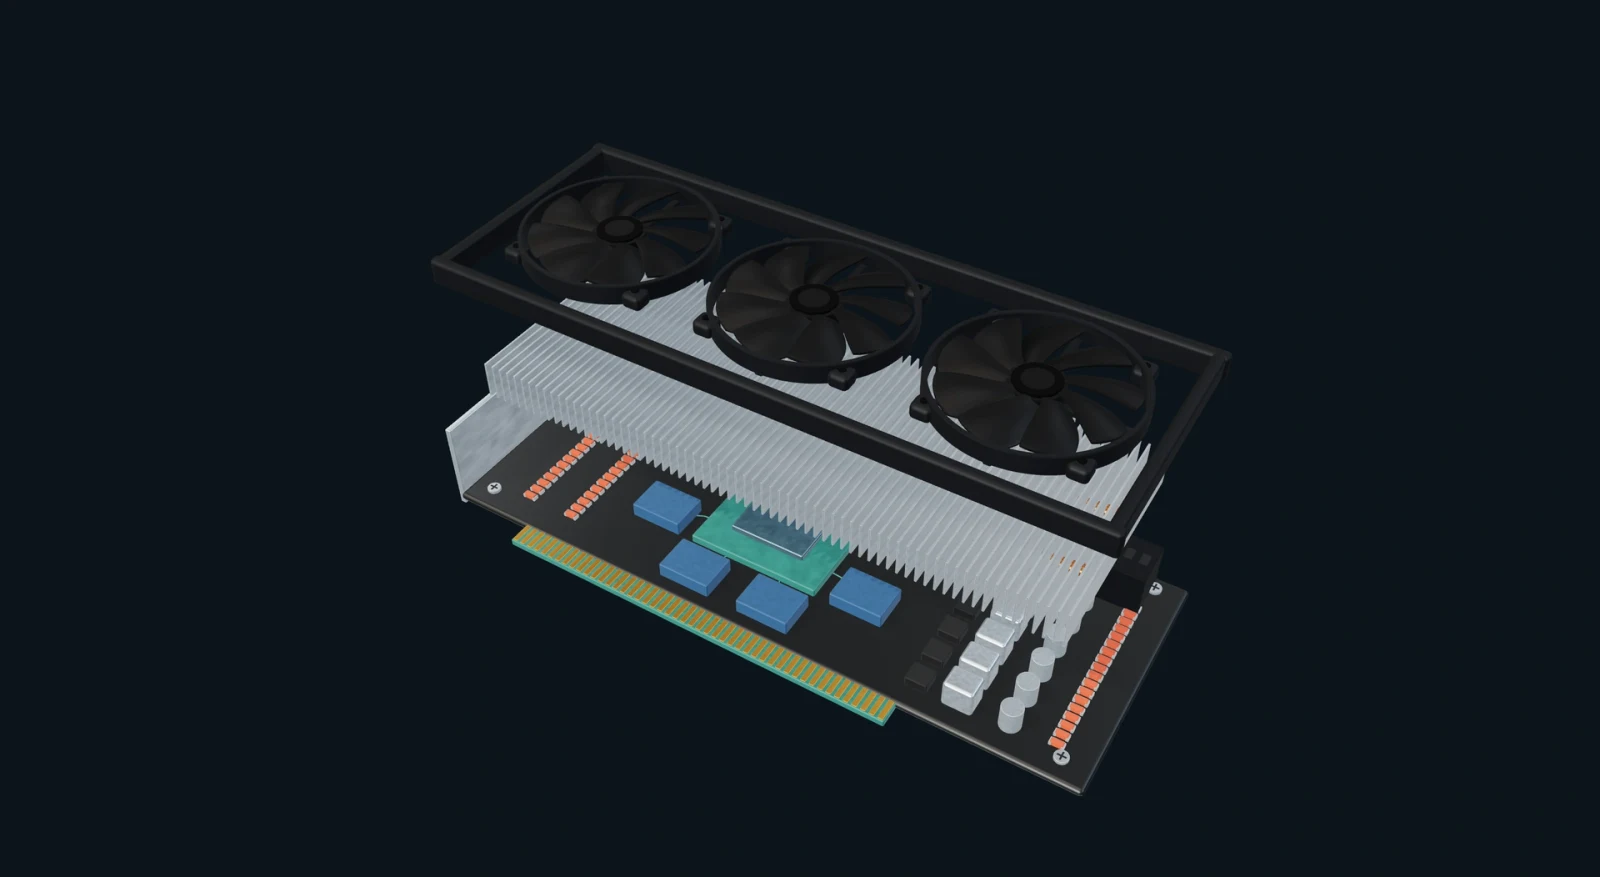
¿Dónde pueden ocurrir estos cálculos? Una tarjeta gráfica dedicada tiene un chip de procesamiento, memoria cercana, alimentación y piezas de refrigeración. Estas piezas cumplen funciones distintas: los ventiladores grandes extraen el calor, mientras que el chip hace los cálculos. Localizarlas en el modelo nos da un lugar para cada tarea. Dentro del chip podemos examinar cómo se organiza el trabajo sobre nuestra imagen.
Los seis botones corresponden a seis grupos de piezas de esta misma tarjeta gráfica. Empecemos por el chip: una marca numerada y un recuadro de localización señalan la pieza seleccionada, y su nombre permanece al lado. Puedes enfocar esa pieza y luego volver a la tarjeta completa. Al separar u ocultar temporalmente el conjunto de refrigeración se ve mejor la placa de circuito que hay debajo. Son vistas de inspección para observar con comodidad, no el aspecto de la tarjeta en funcionamiento.
Seguir un valor a través de esta tarjeta
Elige un valor de escala de grises y avanza paso a paso desde el almacenamiento al cálculo y de vuelta. La pieza seleccionada en el objeto físico y el registro de abajo corresponden a la misma operación.
El marcador señala los datos que se siguen. Su ruta representa un traspaso funcional, no un trazado de cables ni una forma de onda de tensión medidos.La refrigeración solo se retira en esta vista de inspección.Chip de GPU
El pequeño cuadrado expuesto es el chip de procesamiento. Sus circuitos ejecutan instrucciones y calculan resultados. GPU son las siglas de graphics processing unit (unidad de procesamiento gráfico), y la placa entera se llama tarjeta gráfica. Una GPU también puede integrarse en un encapsulado de procesador más grande, sin necesidad de una tarjeta gráfica independiente.
Modelo original en Blender de una tarjeta gráfica discreta representativa. Combina piezas reconocibles sin pretender reproducir el trazado exacto de un fabricante concreto. La organización interna del chip se explica por separado más adelante.
Hacer el mismo trabajo a la vez
Mantenemos sin cambios los dieciséis valores de píxel originales. Cada valor pasa por la misma regla: sumar veinte y conservar 255 si se supera. Una posición de trabajo es un lugar que puede realizar este cálculo; no es una coordenada de la imagen. Empecemos con una sola posición de trabajo, de modo que una ronda termina un píxel. La otra ejecución usa cuatro posiciones con la misma capacidad, así que una ronda puede terminar cuatro píxeles distintos.
Pulsa “Completar la siguiente ronda” para procesar los siguientes píxeles aún sin calcular. La imagen marcada como “Entrada original” conserva la entrada, y “Salida guardada” recibe las respuestas. Un resultado todavía en blanco significa que ese píxel aún no se ha procesado; una marca de verificación señala los píxeles terminados en la ronda más reciente. Puedes pulsar un píxel en cualquiera de las dos imágenes para seguir sus valores abajo.
Los números pequeños de las esquinas identifican los píxeles; los números grandes son valores de gris. Las muestras grises ilustran esos valores y no son mediciones calibradas de intensidad luminosa.
Las posiciones de trabajo están listas
Seguir el píxel 1
Su valor original es 40. Este grupo todavía no ha procesado el píxel 1, por lo que aún no hay una salida guardada. Está previsto procesarlo en la ronda 1, en el puesto de trabajo 1. Sigue avanzando para ver aparecer el resultado.
Comparar las dos ejecuciones
Alternar entre una y cuatro posiciones conserva el progreso de cada ejecución. Ambas usan las mismas dieciséis entradas y la misma regla de cálculo; solo cambia el número de posiciones de trabajo. Completa las dos para comprobar si las respuestas coinciden aunque el número de rondas sea distinto.
| Posiciones | Rondas completadas / necesarias | Píxeles completados / todos |
|---|---|---|
| 1 | 0 / 16 | 0 / 16 |
| 4 | 0 / 4 | 0 / 16 |
Con una posición hacen falta dieciséis rondas; con cuatro, cuatro rondas. Esto es posible porque el cálculo del píxel 2 no necesita conocer primero el nuevo valor del píxel 1. No hemos acortado un cálculo, sino que hemos organizado distintos cálculos para que ocurran a la vez. La pausa de seis segundos por ronda al reproducir sirve para observar mejor y no mide el tiempo del hardware real; tampoco esos números de rondas garantizan que una GPU real sea exactamente cuatro veces más rápida.
Revisar cada cálculo completado en esta ejecución
Todavía no hay cálculos completados. Primero completa la primera ronda arriba.
Hacer trabajo al mismo tiempo es ejecución paralela. El rendimiento describe cuánto trabajo se completa en un tiempo dado; la latencia es el tiempo que una tarea espera desde su inicio hasta su finalización. Nuestro ejemplo de cuatro posiciones mejora el tiempo total de finalización de los píxeles independientes, pero no demuestra que cada instrucción individual tenga menor latencia. Las CPU también usan paralelismo, y una GPU sigue necesitando trabajo, datos e instrucciones adecuados para mantener sus recursos ocupados.
Dentro del procesador
Un programa es una lista de instrucciones: operaciones concretas como leer un valor o sumar veinte. Un hilo es una ejecución de esas instrucciones con sus propios valores de trabajo. Nuestro ejemplo de píxeles asigna un píxel a cada hilo. Ahora el chip de la GPU debe ofrecer lugares donde ejecutar esas instrucciones: el almacenamiento guarda valores, el control decide qué instrucción lista se emite y las unidades aritméticas operan sobre los valores. La figura siguiente es un mapa de responsabilidades dentro del chip, no una imagen microscópica del cuadrado metálico de arriba.
40 · 100 · 180 · 230
Memoria del dispositivo → caché cercana → registros
Elegir trabajo listo; emitir la siguiente instrucción
Muchos carriles aritméticos, organizados en grupos repetidos
| Píxel | Entrada original | Copia en el registro | Instrucción enviada | Resultado del cálculo | Almacenamiento actual del dispositivo |
|---|---|---|---|---|---|
| 1 | 40 | 40 | — | — | 40 |
| 2 | 100 | 100 | — | — | 100 |
| 3 | 180 | 180 | — | — | 180 |
| 4 | 230 | 230 | — | — | 230 |
Seguimos con los cuatro primeros píxeles de la imagen anterior: 40, 100, 180 y 230. Antes de cualquier suma, estos números están guardados en la memoria del dispositivo. La lectura hace una copia de trabajo en un almacén pequeño y cercano llamado registro; no borra el original. Abajo, cada fila mantiene el mismo número de píxel de principio a fin. En esta etapa solo las columnas de entrada y de registro contienen números; el resultado aún no se ha calculado.
Una caché es un almacén pequeño y cercano que conserva parte de los datos para evitar repetir un acceso más lejano a memoria. Algunas arquitecturas ofrecen además una pequeña zona de memoria que comparte explícitamente un grupo de hilos que cooperan. Los tamaños, nombres y organización concretos varían. En la terminología de NVIDIA, un multiprocesador de streaming (SM) contiene recursos de planificación, cálculo y almacenamiento, y un warp es un grupo de planificación formado por 32 hilos. En el diagrama reducimos la cantidad a cuatro para poder observarlo pieza por pieza; no afirmamos que los warp reales tengan solo cuatro hilos.
En la computación con GPU, las instrucciones de una operación elegida se pueden empaquetar en una función: una parte con nombre de un programa que realiza una tarea. Un kernel es una función así, lanzada sobre muchos hilos. En nuestro ejemplo, cada hilo puede recibir un píxel, leer su valor, sumar veinte y guardar el resultado. Los hilos suelen agruparse para que el hardware organice y comparta recursos. La expresión SIMT, «una instrucción, múltiples hilos», describe esta forma de ejecutar una instrucción común en varios hilos con datos separados.
Qué trabajos deben esperar
El ejemplo de los píxeles funcionó bien porque cada respuesta podía obtenerse sin esperar a otra. Dos cambios pueden dificultar mantener el trabajo agrupado: una operación posterior puede necesitar un resultado anterior, o los hilos de un grupo pueden necesitar rutas de instrucciones distintas. Veamos esos casos por separado.
Una cadena de resultados dependientes
Ahora cambiamos de tarea. Empieza en 10, suma 3 y usa esa respuesta como entrada de la siguiente suma. Este procedimiento escrito exige que cada paso lea el resultado del anterior. “Siguiente paso” despliega un eslabón; las posiciones de trabajo libres no pueden saltarse una entrada que aún no existe.
Por ahora solo está listo el valor inicial 10.
Esta cadena de reglas es especialmente sencilla, así que podríamos reescribir el algoritmo y hacer que cada posición calcule directamente su propio valor. Eso cambiaría la forma de organizar el trabajo. La lección consiste en examinar las dependencias del algoritmo real, en lugar de suponer que con más hardware desaparecen automáticamente.
Cuando un grupo necesita instrucciones distintas
Ahora usamos una regla nueva: los valores menores que 128 se aclaran en 20 y los demás se oscurecen en 20. Elegir entre distintas rutas de instrucciones se llama bifurcación. Un grupo que emite instrucciones a la vez no puede tratar dos operaciones diferentes como una misma instrucción. En este recorrido simplificado, mientras se ejecuta una ruta, los carriles que cumplen su condición trabajan y los demás esperan. Al pasar a la otra ruta, los carriles que esperaban realizan su propia operación. Los carriles en espera conservan sus valores y no aplican la regla equivocada.
Este grupo necesita 2 rutas de instrucciones. Los distintos hilos han elegido operaciones diferentes y necesitan dos rutas; esto se llama divergencia de ramas. El modelo cuenta rutas, no ciclos de reloj del hardware; la planificación real y la forma de reunir las distintas rutas dependen de la arquitectura y del programa.
La memoria también puede hacer esperar a la aritmética. Si los valores no han llegado, no basta con tener una unidad aritmética libre. El planificador suele poder ejecutar otro grupo listo mientras uno espera. Así se oculta parte de la espera haciendo otro trabajo, pero no hace instantáneo el acceso a memoria original ni crea trabajo útil cuando no hay ninguno listo.
Contar también el tiempo de ida y vuelta de los datos
Con una GPU dedicada, los datos de entrada pueden tener que pasar de la memoria principal del ordenador a la memoria del dispositivo, hay que lanzar el trabajo y los resultados pueden tener que volver. Esos traslados y la preparación llevan tiempo. Mantener en el dispositivo los datos que se reutilizarán puede reducir viajes repetidos. Las GPU integradas y los sistemas de memoria unificada organizan el almacenamiento de otro modo, pero la disponibilidad y el movimiento de los datos siguen importando.
Aquí una unidad de tiempo inventada representa el tiempo que tarda una posición de trabajo en completar una tarea. En las dos máquinas didácticas todas las posiciones son igual de rápidas. La primera tiene una sola posición; la segunda tiene cuatro, pero necesita tiempo adicional de preparación y transferencia. Si cambias la cantidad de trabajo, puedes comparar cuál es más rápida con el mismo coste. Si mantienes esa cantidad fija y ajustas el coste adicional, ves por separado el efecto del coste. Son supuestos para razonar, no datos de rendimiento medidos.
Un puesto completa una tarea por unidad de tiempo, así que 16 tareas necesitan 16 unidades. Cuatro puestos completan cuatro tareas independientes por tanda; por tanto, tandas necesitan 4 unidades. Por último añadimos el coste adicional: unidades. En este ejemplo, la máquina de cuatro posiciones termina antes.
Si el número de elementos de trabajo no es divisible entre cuatro, todavía hace falta un lote final parcialmente lleno. Por ejemplo, diez elementos forman dos lotes completos de cuatro y un último lote de dos, es decir, tres lotes. El número de lotes es el número de elementos dividido entre cuatro y redondeado hacia arriba. Las posiciones vacías de ese lote final no crean trabajo completado adicional.
Ahora conectemos las piezas de la explicación. Una GPU puede ser eficaz cuando una gran cantidad de trabajo adecuado mantiene ocupados muchos recursos de ejecución, cuando las instrucciones encajan con la agrupación y cuando los datos se mueven con eficiencia. Tener más núcleos o más capacidad de memoria por sí solo no resuelve la cuestión. Una comparación real debe medir la carga de trabajo prevista, incluidos los traslados pertinentes, en lugar de multiplicar el número de carriles de un esquema didáctico para prometer una aceleración.
Del triángulo a los píxeles de la pantalla
Nuestro ejemplo de la foto empezaba con valores de píxel ya guardados. Un juego suele empezar antes, con las superficies de los objetos descritas por muchos triángulos. Un triángulo queda fijado por tres puntos de esquina, llamados vértices. El programa aporta esos puntos y una posición de observación; la GPU transforma sus coordenadas a la vista actual y determina qué partes de la pantalla cubren.
Aquí los tres vértices ya están situados en la vista de pantalla. El contorno naranja los une en un solo triángulo. La cuadrícula representa los píxeles de la pantalla; sus celdas están muy ampliadas para poder examinarlas una a una.
Haz clic en un píxel para comprobar la decisión de cobertura. Toma la esquina superior izquierda como (0, 0), mide x hacia la derecha y y hacia abajo, en anchos de celda. Los tres vértices del triángulo son (0, 0), (6, 0) y (0, 6). Al avanzar una unidad a la derecha a lo largo del lado inclinado, y disminuye una unidad, así que el lado cumple . Un centro cuya suma es menor queda dentro; la igualdad se excluye por la regla de borde establecida.
Centro seleccionado: (0.5, 0.5); 0.5 + 0.5 = 1 < 6. Dentro — recibe color en el paso 3.
En una escena tridimensional, varios triángulos pueden llegar a la misma posición de pantalla. Un valor de profundidad registra a qué distancia está una superficie a lo largo de la vista y una prueba de profundidad puede conservar la superficie visible más cercana y descartar la que queda oculta detrás. El renderizado también trata texturas, iluminación, transparencia y bordes. Nuestro único triángulo plano aísla un puente necesario: una superficie geométrica debe convertirse en valores que la pantalla pueda mostrar. Muchas de las operaciones por vértice y por fragmento aportan el trabajo repetitivo que conviene a una GPU.
Volver a usar estas ideas
1. Se asignan diez píxeles independientes a cuatro posiciones igual de rápidas. ¿Cuántos lotes se necesitan?
Ver el razonamiento
El primer lote termina cuatro y el segundo otros cuatro, así que quedan . Los dos píxeles restantes aún necesitan un tercer lote. Por lo tanto, se necesitan tres lotes; en ese lote final dos posiciones quedan sin usar.
2. En el modelo didáctico, cuatro tareas tardan cuatro unidades de tiempo en una posición. Cuatro posiciones necesitan una unidad de cálculo más ocho unidades adicionales. ¿Cuál termina primero?
Ver el razonamiento
El total con cuatro posiciones es , mientras que el total con una posición es 4. Aquí la máquina de una posición termina primero. El cálculo paralelo ahorró tres unidades, pero el coste adicional añadió ocho. Esto explica los supuestos del modelo, no es una clasificación general de CPU frente a GPU.
3. ¿Por qué duplicar la capacidad de la memoria de vídeo no equivale a duplicar la velocidad de procesamiento de imágenes?
Ver el razonamiento
La capacidad indica cuántos datos caben. Si los datos ya caben, más espacio puede no cambiar este cálculo. La velocidad puede estar limitada por la capacidad aritmética, las dependencias entre instrucciones, los traslados o el ancho de banda de memoria. Primero hay que identificar cuál de estos límites frena realmente esta tarea.