Biología · Estructura molecular
ADN, ARN e información genética
Una pequeña herida de la piel puede cicatrizar porque las células fabrican material nuevo y se dividen en condiciones adecuadas. Pero ¿cómo reciben las células nuevas la información necesaria? ¿Y cómo usa una célula la información guardada para producir algo que funcione? Son dos preguntas diferentes. Replicar el ADN responde a la primera; la producción de ARN y proteínas ayuda a responder a la segunda.
Si ADN, gen y ARN ya parecen una lista para memorizar, déjala de lado un momento. Solo tenemos dos preguntas concretas: cómo se transmite la información y cómo se utiliza. Las mantendremos presentes al pasar de una célula a un segmento seleccionado de su ADN. Explicaremos qué hacen genes, nucleótidos y ribosomas cuando el ejemplo los necesite, y sus significados quedarán junto al modelo.
Esta lección se centra principalmente en células humanas con núcleo. Las formas moleculares, separaciones, colores y secuencias didácticas están simplificados; no son vídeos de células vivas en tiempo real ni resultados de mediciones de estructuras atómicas.
1. Empezar con una célula que necesita funcionar
Tu cuerpo está formado por muchas células. Una célula es una pequeña unidad de vida. La membrana celular separa el interior del entorno y regula el intercambio de sustancias; no es un muro sólido que impida todo paso. Dentro, las moléculas fabrican materiales, liberan energía utilizable y transportan sustancias. Una molécula es un grupo de átomos unidos; los átomos son unidades muy pequeñas de la materia y, al reorganizarse, forman sustancias químicas distintas. En este capítulo seguiremos tres cosas: la célula, su membrana y las moléculas que realizan esas tareas.
Muchas de las moléculas que realizan estas tareas son proteínas. Una proteína contiene una o más cadenas de aminoácidos, pequeñas unidades moleculares. Su orden influye en cómo se pliega la cadena y en lo que puede hacer la proteína. No basta con disponer de materias primas: la célula también necesita determinar cómo ordenarlas.
Hemos dicho que la célula necesita conservar un orden, y eso nos lleva al ADN, el ácido desoxirribonucleico, una sustancia que almacena información de secuencias biológicas. «Información» puede sonar abstracto; después seguiremos el orden de sus unidades y veremos cómo otras moléculas lo utilizan. Por ahora, encontremos el material. En el modelo de célula humana, la mayor parte del ADN está en el núcleo, una región rodeada por su propia envoltura. Las mitocondrias también contienen algo de ADN; este ejemplo sigue el nuclear.
2. Seguir el mismo material sin perder su ubicación
Ampliar una estructura pequeña revela detalles, pero puede despertar otra pregunta: «¿Sigo viendo el mismo segmento?». Una célula y una molécula de ADN tienen tamaños tan distintos que necesitamos varias ampliaciones. Antes de pulsar «Siguiente», localiza la selección naranja. La vista cambia, pero el naranja permite reconocer el mismo material seleccionado. Si pierdes la orientación, consulta el pequeño esquema inferior, que conserva su ubicación original.
Los filamentos morados del núcleo representan la cromatina, el ADN y las proteínas que lo organizan. La parte naranja es un segmento seleccionado de esos filamentos. Al distinguir después el ADN y las proteínas alrededor de las que se enrolla, revelamos la composición de la propia cromatina; no descubrimos otro material ajeno en su interior.
Violeta = cromatina. Naranja = un pequeño fragmento seleccionado de esa misma cromatina.
Célula y núcleo
Empezamos con una célula animal simplificada. El borde verde exterior es la membrana celular; la región morada más pequeña es el núcleo. Para ver el interior, hemos cortado la mitad delantera de la membrana y de la envoltura nuclear. Las células reales no tienen estos cortes abiertos.
Busca primero el pequeño segmento marcado en naranja dentro del núcleo morado. Lo seguiremos durante los próximos pasos.
Vuelve a observar la unidad de enrollamiento, el nucleosoma: ADN alrededor de un núcleo de ocho histonas. Las histonas son proteínas, no otro nombre del ADN. Muchas unidades así ayudan a organizar una molécula larga. El modelo separa las unidades para mostrar sus conexiones; la cromatina celular no siempre forma una fibra uniforme enrollada de manera regular.
Tampoco podemos usar ADN y cromosoma como sinónimos. Un cromosoma es una unidad organizada de este material de ADN y proteínas. Antes de replicarse, un cromosoma nuclear humano contiene una molécula muy larga de ADN de doble cadena y proteínas asociadas. Aunque esté extendido y resulte difícil distinguirlo al microscopio, sigue siendo un cromosoma; no necesita tener forma de X.
3. Por qué una X contiene dos moléculas de ADN
Para aclarar las cantidades, elegimos una célula humana típica con dos juegos de cromosomas: uno de cada progenitor, de 23 cada uno, 46 en total. Es nuestro ejemplo, no una descripción de todas las células humanas. Los óvulos y espermatozoides suelen tener 23 cada uno; los glóbulos rojos humanos maduros no tienen núcleo. Algunas otras células especializadas tampoco encajan en este ejemplo.
Antes de una división ordinaria, cada molécula de ADN se replica. Las copias quedan en dos cromátidas hermanas y permanecen unidas temporalmente. Cada cromátida es una copia de ADN y proteínas. La región estrecha del centro de la X, llamada centrómero, es la zona de unión que solemos reconocer. Cada cromátida contiene una molécula completa de ADN de doble cadena. Por tanto, las mitades de la X no son las dos cadenas de una única doble hélice.
Mientras las hermanas siguen unidas en el centrómero, constituyen una unidad y cuentan como un cromosoma replicado. La cantidad de ADN ya se ha duplicado, pero el número de cromosomas aún no. Solo después de separarse, cada una cuenta como un cromosoma. En una división ordinaria, cada célula hija recibe una copia de cada cromosoma.
Seguir primero un solo cromosoma
1 cromosoma · 1 molécula de ADN
La línea gruesa representa una unidad de ADN y proteínas: es un esquema de un cromosoma completo, no una cadena de una molécula de ADN.
El esquema superior sigue un solo cromosoma. Para verlos todos, vuelve al modelo tridimensional del capítulo 2 y pulsa «Comparar los cromosomas durante la división»: muestra 46 cromosomas replicados con 92 moléculas de ADN. Están separados y ordenados para contarlos, sin representar sus posiciones aleatorias en una célula viva ni la placa metafásica. La X indica un cromosoma condensado y replicado, no que todos sean el cromosoma sexual llamado X. La desintegración de la envoltura nuclear y la condensación también llevan tiempo; no ocurren por completo en un instante al pulsar un interruptor.
4. Cómo se aparea una cadena de ADN con otra
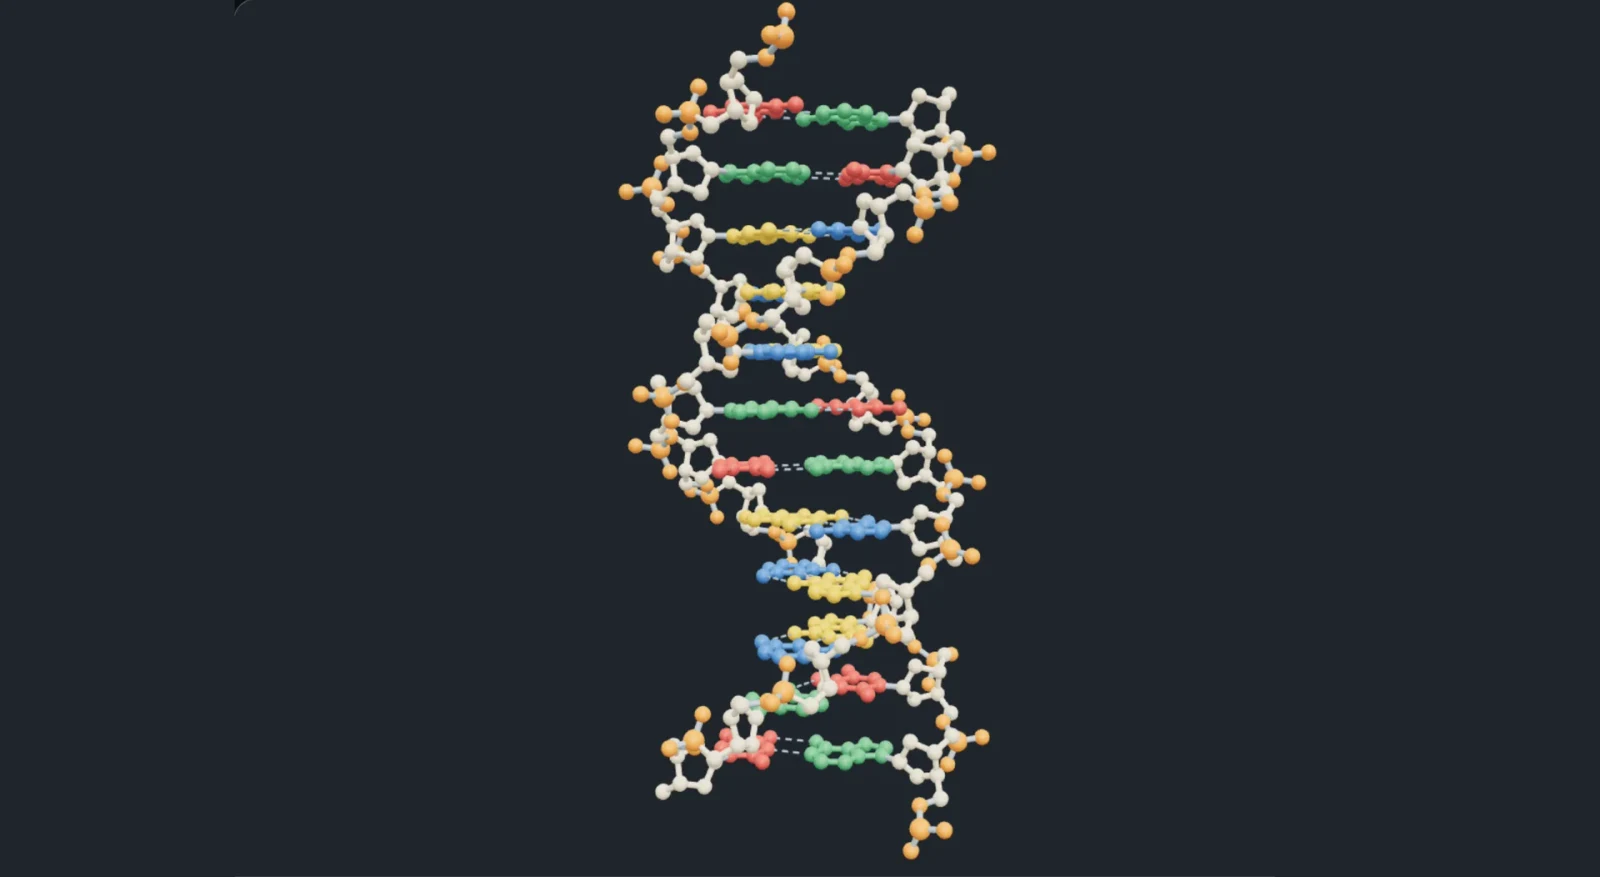
Volvemos a la molécula de ADN. La materia está formada por átomos y los enlaces químicos pueden unirlos en moléculas. Un nucleótido es una unidad repetida de la cadena de ADN con tres partes conectadas: un grupo fosfato, el azúcar desoxirribosa y una base. La base es solo una parte; no debe confundirse con el nucleótido completo.
Las cuatro bases habituales del ADN son adenina A, timina T, guanina G y citosina C. Usamos letras porque es más fácil seguir doce letras que doce nombres químicos largos. La unión repetida de azúcares y fosfatos forma el esqueleto; cada azúcar también lleva una base. Cambiar una letra cambia la base, no la forma básica de conectar todo el esqueleto.
Colocamos la segunda cadena junto a la primera. El ADN suele aparearse según A con T y G con C. Este apareamiento complementario tiene formas y disposiciones atómicas compatibles que permiten enlaces de hidrógeno. Son atracciones entre grupos atómicos concretos, distintas de los enlaces covalentes que mantienen unido el esqueleto de cada cadena.
Un nucleótido
Un nucleótido es una unidad básica de la cadena de ADN. El naranja indica el grupo fosfato, el beis el azúcar desoxirribosa y el verde la base A. Las varillas sólidas representan enlaces covalentes entre átomos. Pulsa un componente para atenuar los demás; arrastra o restablece la vista para examinar la estructura tridimensional.
Las esferas son una manera de dibujar átomos, no sus superficies reales. Se omite la mayoría de los hidrógenos para no ocultar los enlaces que queremos observar.
A–T suele formar dos enlaces de hidrógeno y G–C, tres. Pero sería incompleto decir que solo esos enlaces mantienen la estructura del ADN. Las bases vecinas también se apilan dentro de la hélice y las interacciones de apilamiento contribuyen mucho a estabilizarla. Observa tanto un par transversal como el apilamiento de bases a lo largo de la hélice.
Algunas partes de la molécula son aproximadamente planas, como los anillos de las bases; otras se extienden en tres dimensiones. Un modelo preciso debe conservar ambas características. Gira el nucleótido, observa el anillo de azúcar plegado y el fosfato tridimensional y compáralos con la base. Esferas y varillas son convenciones para dibujar átomos y enlaces, no fotografías de sus superficies.
5. Una secuencia también necesita una dirección
Los carbonos del azúcar de cada nucleótido están numerados. y designan dos posiciones y se leen «cinco prima» y «tres prima». Los nucleótidos vecinos se unen mediante fosfato: la posición de un azúcar se conecta a la del siguiente. Por eso, los dos extremos de una cadena tienen propiedades químicas distintas. El signo prima distingue la numeración de los átomos del azúcar; no indica derivada, tiempo ni longitud.
Las cadenas del ADN tienen sentidos opuestos. Si la superior va de a la izquierda a a la derecha, la complementaria va de a la izquierda a a la derecha. Se llama antiparalelismo y describe su orientación química, no un movimiento en direcciones contrarias.
Usamos las mismas doce posiciones del modelo estructural. En cada una, elige la pareja que debe quedar justo debajo de la base existente. En la posición 1, arriba hay y abajo debe haber . En la 2, arriba hay y abajo, . Registramos posiciones enfrentadas de izquierda a derecha; todavía no hemos reescrito la cadena inferior en su propio sentido de lectura, de a .
Completar la cadena complementaria posición por posición
Selecciona una posición numerada y utiliza A, T, G o C debajo para cambiar su base. La columna resaltada contiene las dos bases enfrentadas.
¿Qué base debe emparejarse con A, situada arriba en la posición 1?
Has completado 0/12 posiciones complementarias. Cada cadena conserva su dirección química original.
Una secuencia de ADN aislada suele escribirse de a . Encontrar su complementaria consiste en elegir la base pareja en cada posición. Eso determina las bases, pero el orden mostrado puede ir de a . Para escribirlo de a debemos invertir ese orden. En estas doce posiciones, la cadena inferior es 3′–TACGCATGCGAT–5′ de izquierda a derecha; leyéndola desde la posición 12 hacia atrás resulta 5′–TAGCGTACGCAT–3′. Cambia la dirección de escritura, no la molécula.
6. ¿Qué significa exactamente que el ADN contiene información?
El armazón de azúcar y fosfato se repite, pero el orden de bases puede cambiar. ATG y AGT tienen las mismas tres letras en distinto orden. Las moléculas que interactúan con esos segmentos pueden distinguirlo. Por eso, la secuencia influye en qué fabrica la célula y cuándo. Aquí información significa un orden que puede copiarse y utilizarse mediante interacciones moleculares, no que las letras comprendan su significado.
Un gen es una secuencia de ADN que se utiliza para fabricar un ARN funcional. Algunos ARN llevan instrucciones para producir proteínas; la célula lee la parte correspondiente y determina qué aminoácidos usar. Otros ARN realizan tareas por sí mismos y no sirven para fabricar proteínas, como los ARNt y ARNr que veremos después. Decir que «todos los genes fabrican proteínas» omitiría una clase importante de genes.
No todo el ADN codifica proteínas. Algunas regiones ayudan a regular cuándo se usa un gen; otras tienen funciones estructurales u otras tareas, y algunas aún no se comprenden completamente. Todo el ADN de un organismo constituye su genoma. Un cromosoma es una parte organizada de ese conjunto, no un gen; puede contener muchos genes y otras secuencias.
El ejemplo de doce bases sirve para practicar estructura y apareamiento; no es un gen humano funcional completo. Contener A, T, G y C, o incluso una secuencia corta conocida, no basta para formar un gen con todas las señales necesarias para utilizarlo.
Si solo hay cuatro letras, ¿cómo puede haber tantas secuencias distintas?
Una posición ofrece cuatro opciones: A, T, G o C. Añadamos una segunda posición. Para cada elección de la primera hay cuatro opciones en la segunda: después de A podemos formar AA, AT, AG y AC; después de T, G o C también hay cuatro. Son cuatro grupos de cuatro, en total 16 secuencias de dos letras.
AA AT AG ACTA TT TG TCGA GT GG GCCA CT CG CCLa tercera posición añade cuatro prolongaciones a cada secuencia de dos letras, de modo que la cantidad pasa a ser . Cada posición adicional vuelve a multiplicar por . Escribiendo esa multiplicación repetida como una potencia, posiciones permiten secuencias. Aquí cuenta posiciones, no cromosomas ni aminoácidos.
A T G C4 opcionesA T G C4 opcionesA T G C4 opciones7. Replicar el ADN y seguir el destino de las cadenas antiguas
Volvamos a la pregunta inicial: ¿cómo reciben ambas células hijas la información del ADN? Cortar una molécula por la mitad solo daría parte de la secuencia a cada célula. Por eso se fabrica una copia antes de dividirse. Copiar ADN en ADN se llama replicación del ADN.
El apareamiento complementario ofrece un método. Separamos las cadenas sin cortar ninguno de sus esqueletos. Cada base antigua expuesta determina la nueva que debe colocarse al lado: A antigua con T nueva, T con A, y G y C entre sí. La cadena antigua actúa como molde, una secuencia existente que determina la nueva.
El modelo marca el material original con un esqueleto morado y el nuevo con uno azul; los colores de las bases siguen distinguiendo A, T, G y C. Sigue ambas cadenas antiguas hasta el final. Decir que «obtenemos dos nuevas moléculas de ADN» no significa que todos los átomos de ambos productos tengan que ser nuevos.
Original5′ ATGCGTACGCTA 3′
Nueva3′ ············ 5′
Original3′ TACGCATGCGAT 5′
Nueva5′ ············ 3′
En la vista tridimensional inicial, las posiciones se ordenan de abajo arriba; la fila de letras muestra esas mismas posiciones de izquierda a derecha. Los puntos indican nucleótidos nuevos todavía no añadidos. La fila de letras permite comparar los apareamientos, no indica la dirección de síntesis.
Cada paso permanece nueve segundos durante la reproducción. Si necesitas más tiempo, puedes pausar o avanzar manualmente al siguiente paso.
Empezar con un segmento de ADN de doble cadena
Antes de dividirse, la célula necesita replicar el ADN. Aquí seguimos solo doce pares de bases, no un cromosoma completo. Los dos esqueletos son morados porque ambos pertenecen a cadenas antiguas; los colores de las bases siguen indicando A, T, G y C. La fila inferior conserva esas mismas doce posiciones.
Una molécula de ADN tiene dos cadenas. Cuando cambie el número de moléculas, distingue siempre entre «una molécula» y «una cadena».
Al final, cada doble hélice contiene una cadena antigua y una nueva. Esta es la replicación semiconservativa: una de las dos cadenas de cada producto procede de la molécula original. La cadena antigua aporta el orden y los nucleótidos libres aportan material nuevo. Las bases antiguas no se dividen en dos ni se convierten en la cadena nueva.
Las células reales necesitan algo más que una regla de apareamiento. Este párrafo y el siguiente añaden detalles que puedes omitir en una primera lectura. La helicasa es una máquina molecular que ayuda a abrir localmente la doble cadena. La ADN polimerasa es una enzima que añade los nucleótidos adecuados a la cadena en crecimiento. Las enzimas facilitan reacciones químicas y muchas son proteínas. La polimerasa necesita un extremo inicial existente, aportado por un pequeño cebador, y añade unidades al extremo de la nueva cadena. Por tanto, el ADN nuevo crece de a .
La zona abierta avanza por el ADN antiguo; su extremo ramificado se llama horquilla de replicación. Como los moldes tienen orientaciones opuestas, las cadenas nuevas no pueden alargarse en el mismo sentido. Una crece en la dirección de avance de la horquilla; la otra lo hace por fragmentos cortos que crecen alejándose de ella. Cada fragmento sigue sintetizándose de a . Tras retirar los cebadores y sustituirlos por ADN, la ADN ligasa sella las discontinuidades del esqueleto para formar una cadena continua; la segunda cadena no se sintetiza al revés.
La animación explica específicamente el apareamiento y el destino del material antiguo. Desplegar una escalera recta y completar posiciones simultáneamente son decisiones de presentación, no una cronología enzimática completa. El modelo también supone una copia correcta. Las células tienen mecanismos de corrección y reparación, pero a veces quedan errores; un cambio de secuencia del ADN se llama mutación.
8. Una copia para transmitir y otra para utilizar
Ya podemos distinguir dos procesos que pueden confundirse. La replicación copia ADN en ADN para transmitir el genoma durante la división. La transcripción usa un segmento seleccionado de ADN como molde para fabricar ARN. Para un producto de ARN concreto se lee una de las dos cadenas y el ADN original se conserva.
ARN significa ácido ribonucleico. También está formado por nucleótidos, pero su azúcar es ribosa, no desoxirribosa, y sus bases habituales son A, U, G y C. U es uracilo. Durante la transcripción, una A del molde de ADN recibe una U de ARN; durante la replicación recibiría una T. El ARN suele ser monocatenario, aunque regiones de la misma cadena pueden aparearse y plegarse en tres dimensiones.
La traducción es un tercer proceso: usar la secuencia del ARNm, el ARN mensajero, para ensamblar una cadena de aminoácidos. La cadena informativa aporta el orden y los aminoácidos el material; el ARNm no se convierte en proteína. Observaremos por separado el ARNm, el ARNt que transporta aminoácidos y el ARNr del ribosoma que ensambla la cadena.
Replicación
Conservar el genoma para la división celular
Cada cadena antigua sirve de molde para formar una nueva cadena complementaria de ADN.
Transcripción
Producir ARN para su uso
Una cadena seleccionada de ADN sirve de molde y determina la secuencia de una cadena de ARN.
Traducción
Ensamblar una cadena de aminoácidos
El ribosoma y el ARNt utilizan los codones; el propio ARN sigue siendo ARN.
Las flechas indican que se utiliza información para fabricar un producto con materiales nuevos; no que la molécula de la izquierda se transforme directamente en la de la derecha.
9. Seguir tres tipos de ARN y ver cómo trabajan
En el taller siguiente cambiamos deliberadamente a otro ejemplo corto. ATGCGTACGCTA servía para practicar el apareamiento del ADN; aquí, después del procesamiento del ARN, el mensaje es AUG GCU UUU UAA. Así podemos seguir tres aminoácidos y una señal de terminación sin esconder pasos en una secuencia larga. Son dos ejemplos didácticos independientes, no estados anteriores y posteriores de la misma molécula.
La explicación siguiente presenta proteínas y ARN. Con estos objetos entenderemos qué hacen ARNm, ARNt, ARNr y el ciclo de ensamblaje. Cada capítulo tiene una vista estable; «Reproducir» muestra solo el paso actual y se detiene al terminar, y tú decides cuándo pulsar «Siguiente». Solo necesitas girar o ampliar si quieres examinar la estructura; si pierdes la orientación, «Restablecer la vista» recupera la posición del capítulo.
Cómo utiliza la célula la información del ADN
Una secuencia de ADN todavía no es una proteína funcional
La célula no solo guarda ADN: debe transportar sustancias, mantener su forma y realizar reacciones químicas. Muchas moléculas que hacen estas tareas son proteínas. Por ejemplo, la hemoglobina ayuda a transportar oxígeno en la sangre y muchas enzimas son proteínas que permiten que reacciones concretas ocurran a la velocidad necesaria.
Las proteínas contienen una o más cadenas de pequeñas moléculas llamadas aminoácidos, que no son las bases del ADN. Abajo, las esferas ámbar representan aminoácidos y las unidades de colores con letras representan bases del ARN, para distinguirlos siempre. El orden de aminoácidos influye en cómo se pliega la cadena y en lo que puede hacer. Algunas cadenas necesitan procesamiento adicional o unirse a otras para funcionar.
La pregunta ya es concreta: el ADN conserva un orden de bases, pero la proteína necesita un orden de aminoácidos. ¿Cómo utiliza la célula el primero para ensamblar el segundo? Seguiremos el mismo ejemplo deliberadamente corto: AUG, GCU, UUU, UAA. Producirá una cadena de tres aminoácidos y después llegará a una instrucción de parada. No es una proteína humana real funcional.
Conocer primero el material: ARN
Como el ADN, el ARN es una cadena de nucleótidos. Cada uno tiene un grupo fosfato, un azúcar llamado ribosa y una base. Sus bases habituales son A, U, G y C. U es uracilo; en posiciones correspondientes, el ARN usa U donde el ADN usa T. El ARN suele tener una sola cadena, pero distintas partes pueden aparearse y plegarla. «Monocatenario» no significa recto y rígido.
Los extremos de una cadena de ARN son químicamente distintos. Los marcamos y , «extremo cinco» y «extremo tres», nombres derivados de la numeración de carbonos del azúcar. Indican dirección, no que haya cinco o tres bases. Los nucleótidos nuevos se añaden al extremo , por lo que escribimos el sentido de síntesis de a . Todas las secuencias de letras de abajo indican su dirección.
ARNm, ARNt y ARNr nombran distintas moléculas de ARN según su función. El ARN mensajero (ARNm) lleva la secuencia que debe leerse; el ARN de transferencia (ARNt) conecta tres bases complementarias con un aminoácido; el ARN ribosómico (ARNr) forma parte de la estructura que lee y une aminoácidos. No son tres formas sucesivas de una misma cadena: el ARNm no se convierte primero en ARNt y después en ARNr.
¿De dónde salen ARNt y ARNr? También se transcriben del ADN y se procesan. Su producto funcional es la propia molécula de ARN plegada, no una proteína fabricada al leerla. Por tanto, los genes pueden producir ARN funcional o mensajes de ARN para fabricar proteínas. El «gen codificante de proteína» que elegimos pertenece al segundo caso.
ARNm: fabricar y transportar una copia de trabajo
Usamos como ejemplo una célula humana con núcleo. Un gen codificante de proteína es una región de ADN cuya secuencia produce un ARN capaz de guiar la fabricación de proteína. El ADN permanece en el núcleo y la célula sintetiza otra molécula de ARN. Copiar así la información se llama transcripción. La copia inicial puede necesitar procesamiento para convertirse en ARNm maduro, legible fuera del núcleo.
Observa la cadena molde de ADN escrita de a . La ARN polimerasa es una enzima que avanza por el molde y sintetiza ARN. Al leer cada base incorpora una base de ARN complementaria: del ADN corresponde a del ARN, a , a y a . Así, TAC del molde produce AUG en el ARN. La secuencia es complementaria; no se extrae una cadena antigua del ADN para cambiarle el nombre.
En la tira inferior se conservarán los dos segmentos sin sombrear y se eliminará el segmento gris rayado. Los conservados son exones y el eliminado, un intrón. Algunos exones incluyen secuencias no traducidas, así que «exón» no significa que todas sus bases fabriquen aminoácidos. Este ejemplo coloreado omite los extremos no traducidos y utiliza un intrón ficticio muy corto para mostrar el proceso principal.
Selecciona un paso numerado y reprodúcelo. Se detendrá automáticamente al llegar al final para que puedas revisarlo. Arrastra suavemente para girar el modelo o pulsa «Restablecer la vista». Usa «Ampliar» para examinar una unión; «Restablecer la vista» vuelve a mostrar toda la operación. La cámara no sigue a las moléculas; la tira de secuencia inferior mantiene legibles la orientación y las letras aunque gires el modelo.
Arriba está la cadena codificante y abajo la molde. Para examinarlas, este segmento se ha enderezado y separado; la transcripción real solo abre localmente el ADN. Las cadenas tienen direcciones opuestas. Lee TAC de izquierda a derecha en la inferior: el ARN nuevo empezará por AUG.
Mantener visible la correspondencia entre las letras
El segmento rayado GUACAG es un intrón ficticio. Al retirar esas seis letras, AUGGCU y UUUUAA se unen conservando el orden original de ambos segmentos.
Volvamos a la pregunta inicial. La información del ADN se transcribe en otra molécula de ARN que se procesa hasta dar ARNm maduro. Los ARNt cargados se aparean sucesivamente con los codones y aportan aminoácidos. El ribosoma, formado por ARNr y proteínas, coloca estas moléculas y facilita unir los aminoácidos. El mensaje determina el orden; no se consume como materia prima de la proteína.
El modelo separa eventos que pueden solaparse en una célula y omite muchas proteínas auxiliares, transferencias de energía y comprobaciones. El ARNm está enderezado para leer la secuencia. Las formas moleculares tridimensionales son modelos didácticos originales hechos en Blender, no estructuras atómicas medidas experimentalmente. Girarlos ayuda a examinar conexiones, pero sus tamaños, colores y velocidades no son resultados de medición.
Comprueba si has relacionado estas ideas
Si el molde empieza por , ¿por qué el ARN empieza por ?
Lee el molde en la dirección indicada: T se aparea con A de ARN, A con U y C con G. La cadena nueva crece por su extremo 3′, en sentido opuesto al molde, y produce 5′–AUG–3′. Usamos apareamiento complementario, no copiamos cada letra de ADN como la misma letra de ARN.
Tras la primera transferencia peptídica, ¿qué ARNt lleva Met–Ala?
El ARNt del sitio A lleva la cadena unida. Antes, P llevaba Met y A Ala; al formar el nuevo enlace, la parte existente se transfiere al aminoácido de A, dejando vacío el ARNt de P. Solo después del siguiente movimiento, el ARNt que lleva la cadena pasará a P respecto del ribosoma.
¿UAA añade un cuarto aminoácido? ¿El ARNm se convierte en proteína?
No ocurre ninguna de las dos cosas. UAA es una instrucción de terminación reconocida con ayuda de un factor de liberación; en este ejemplo del código estándar no añade aminoácidos. El material de la proteína procede de los aminoácidos transportados por ARNt; el ARNm aporta el orden y sigue siendo ARN.
Fuentes científicas:NHGRI · RNA · NHGRI · tRNA · Molecular Biology of the Cell · From RNA to Protein
10. Cambiar la secuencia y seguir las consecuencias
Ya podemos comprobar qué cambia al modificar el orden de las bases. Seguimos con el mensaje corto del taller, AUG GCU UUU UAA. Aquí aparece su cadena codificante de ADN: . Coincide con el ARN salvo que el ADN usa donde el ARN usa . La cadena opuesta de ADN es la que actúa como molde en la transcripción.
Un codón son tres bases de ARN leídas dentro de un marco de lectura definido. El marco indica dónde empezar a formar grupos de tres. Nuestro ejemplo fija el primer AUG como inicio y agrupa consecutivamente, sin saltarse letras ni solapar grupos. El código genético estándar asigna a cada grupo un aminoácido o una señal de terminación; varios codones pueden especificar el mismo aminoácido.
Elige un ejemplo o cambia una letra del ADN codificante de abajo. Una sustitución de base cambia una letra por otra sin alterar el total. El molde complementario y el ARN resultante se actualizan. Sigue una columna hacia abajo: secuencia de ADN, codón de ARN y aminoácido correspondiente. Después del primer codón de terminación, los grupos posteriores siguen en el mensaje, pero no añaden aminoácidos a esta cadena.
La misma información: comparar directamente cuatro resultados
El ADN codificante y el ARN van de a la izquierda a a la derecha; el molde alineado va de a la izquierda a a la derecha. Puedes modificar el ADN con el menú de cada letra; las tres letras iniciales permanecen fijas.
Grupo 1
ADN codificanteADN moldeTACRNAAUGContribución a esta cadenaMet · MetioninaGrupo 2
ADN codificanteADN moldeCGARNAGCUContribución a esta cadenaAla · AlaninaGrupo 3
ADN codificanteADN moldeAAARNAUUUContribución a esta cadenaPhe · FenilalaninaGrupo 4
ADN codificanteADN moldeATTRNAUAAContribución a esta cadenaParar, sin añadir un aminoácidoPosiciones modificadas: 0 · Cadena de aminoácidos: Met — Ala — Phe
AUG, GCU y UUU producen **Met—Ala—Phe**; UAA detiene la lectura y no aporta un aminoácido.
Un cambio sinónimo no modifica la secuencia de aminoácidos en este marco. Eso no demuestra que carezca de efectos en una célula viva: puede afectar al procesamiento, la estabilidad o la traducción del ARN. Tampoco cambiar un aminoácido demuestra por sí solo que cause una enfermedad. Este modelo solo informa del resultado de secuencia para el inicio y marco elegidos; no predice la salud de una persona.
11. Relacionar todo el proceso con tus propias palabras
Vuelve a la célula inicial. La cromatina morada es material de ADN y proteínas; las bases del ADN forman una secuencia, el apareamiento complementario permite copiarla y cada producto de la replicación conserva una cadena antigua. Un segmento elegido también puede transcribirse en ARN. Algunos ARN llevan información; otros actúan como adaptadores o forman parte de la maquinaria que la utiliza.
Intenta responder las preguntas y despliega sus explicaciones. Indica qué materiales hay, qué cambia y qué se conserva. El nombre de un proceso permite nombrarlo, pero todavía no explica cómo ocurre.
¿El ADN seleccionado es un hilo ajeno escondido dentro de la cromatina?
No. Cromatina ya significa ADN y proteínas asociadas. Ampliamos la parte seleccionada para distinguir sus componentes. La selección naranja y los filamentos morados anteriores señalan el mismo material, visto de otra manera; los colores son marcas didácticas.
Una célula tiene 46 cromosomas replicados cuyas hermanas aún no se han separado. ¿Cuántas moléculas de ADN nuclear hay?
Cada cromosoma replicado tiene dos cromátidas hermanas, cada una con una molécula de ADN de doble cadena; por tanto, hay moléculas de ADN nuclear. En esta fase siguen siendo 46 cromosomas replicados. Si contamos cadenas individuales, hay ; eso es otro objeto de recuento.
¿Puede quedar un producto completamente antiguo y el otro completamente nuevo tras replicarse?
No. Las dos cadenas originales actúan como moldes y cada una recibe una nueva complementaria. Los productos son «cadena antigua 1 con su pareja nueva» y «cadena antigua 2 con su pareja nueva». Cada uno contiene una antigua y una nueva. El material original se reparte entre ambos; no queda todo en uno.
Si el molde es , ¿qué ARN se fabrica? ¿Ya se ha producido proteína en este paso?
Aplicamos las reglas del ARN posición a posición: T corresponde a A, A a U y C a G; resulta 5′—AUG—3′. Es transcripción: el producto es una cadena de nucleótidos, todavía no una cadena de aminoácidos. En condiciones de traducción adecuadas, AUG puede servir de inicio, pero esas tres letras por sí solas no forman un gen funcional completo ni una proteína.
Después de transferir el péptido, ¿qué ARNt sigue unido a la cadena? ¿Qué ocurre al llegar a UAA?
La cadena existente pasa del ARNt del sitio P al aminoácido llevado por el ARNt del sitio A. El ARNt anterior queda sin aminoácido y no se lleva la cadena al salir. Después UAA entra en A y señala la terminación. La cadena se libera con ayuda de un factor de liberación, no de un ARNt con aminoácido. En nuestro ejemplo de tres aminoácidos, UAA no añade un cuarto.